API·Ka
L'API centrale du Groupe KA : collecte quotidienne des données des plateformes de l'écosystème, base PostgreSQL unifiée, API publique et KA Agent (IA).




API·Ka (www.api-ka.com) est la plateforme de données centrale de l'écosystème Groupe KA. Chaque jour, 8 collecteurs (lou-ka, immo-ka, food-ka, auto-ka, fabri-ka, resto-ka, sorti-ka, crea-ka) sauvegardent les données des plateformes dans une base PostgreSQL unifiée (fetch → validation → checksum → insertion → backup → journal de run, retry 3× avec backoff 30 s → 2 min → 10 min), puis les exposent via une API FastAPI publique : données paginées, historiques par date, statistiques, rapports PDF.
Elle héberge aussi le KA Agent — l'assistant IA central du groupe (Claude Haiku, SSE, boucle d'outils branchés sur les API publiques des plateformes) servi en widget (/ka-agent.js) aux 13 domaines de l'écosystème — et sert de superviseur des connecteurs (historique des collectes /api/v1/runs, santé par service, alertes). L'accès à l'API produit exige une authentification : session KA ID ou jeton personnel (kapi_, généré sur groupe-ka.com/compte).
Captures d'écran
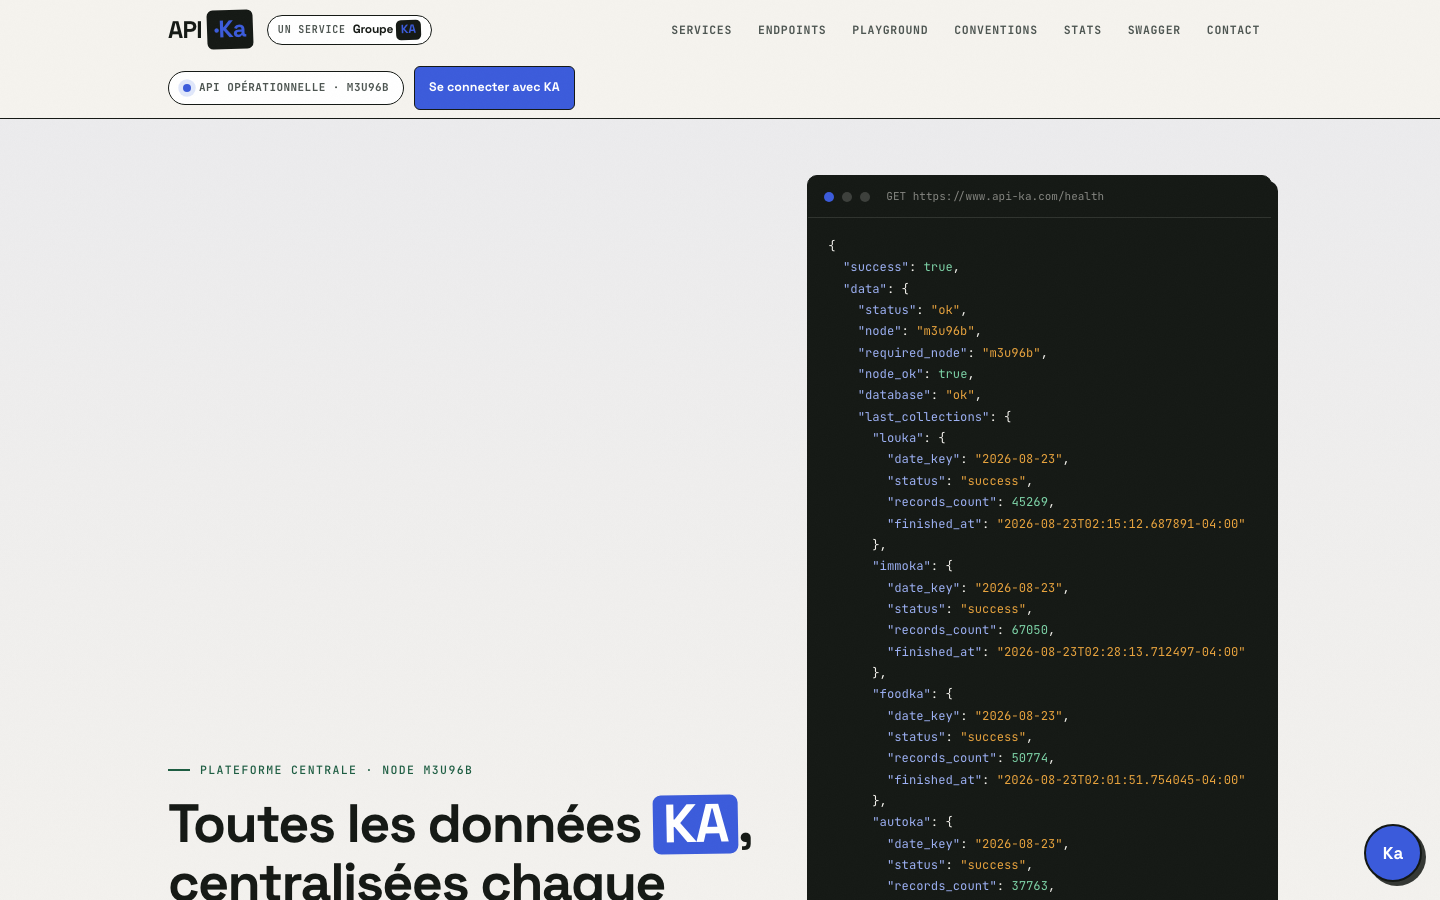
Fonctionnalités
- 8 collecteurs quotidiens — un par plateforme Ka, avec validation, checksum, retry 3× (backoff exponentiel) et journal de run ; tout échec après 3 tentatives est loggé (
collection_runs,logs/alerts.log). - Scheduler APScheduler — job quotidien à 02:00 (collecteurs en parallèle et indépendants) + backfill automatique des dates manquées (7 derniers jours).
- API publique de données —
GET /api/v1/{service}(pagination, limit max 500),/latest,/date/{YYYY-MM-DD},/stats,/api/v1/runs(historique des collectes), pour{service}∈ louka, immoka, foodka, autoka, fabrika, restoka, sortika, creaka. - Authentification obligatoire sur l'API produit — session KA ID ou jeton Bearer
kapi_; monitoring, stats et agent restent ouverts. - KA Agent (IA) —
POST /api/agent/chaten SSE (Claude Haiku, boucle d'outils sur les données live des plateformes : logements, propriétés, véhicules, emplois, épicerie, produits, restos, sorties, créateurs, stats, état des services) + widget embarquableGET /ka-agent.js, CORS ouvert aux 13 domaines. - SSO KA ID —
GET /api/auth/ka/{login,callback}, session/api/auth/me, et échange de jeton pour l'app iOS native (POST /api/ios/auth/exchange, vérification HS256aud=ka-ios). - Stats & rapports — tableau de bord
/stats,GET /api/stats/report(PDF de la plateforme) etGET /api/stats/ecosystem-report(rapport PDF consolidé de l'écosystème, liste dynamique viaecosystem.json) + rapports PDF personnalisés (catalogue + constructeur). - Backups quotidiens horodatés par service (
data/backups/YYYY-MM-DD/, rétention 90 jours). - Santé & supervision —
GET /health(nœud, état DB, dernière collecte par service) ; chaque service vérifie le hostname au démarrage et refuse de tourner en production ailleurs que surm3u96b. - SEO du site de doc — robots.txt, sitemap.xml, canonical/hreflang/JSON-LD.
Architecture
- FastAPI + Uvicorn (
src/api/) : routes health, services, runs, stats, agent, auth, iosauth + pages web et PDF (fpdf2). - PostgreSQL via SQLAlchemy 2 (+ Alembic pour les migrations,
psycopg2) : une table de données par service + journalcollection_runs. - Collecteurs (
src/collectors/) : classe abstraitebase_collector(fetch, validate, save, retry) + 8 collecteurs concrets, httpx. - Scheduler (
src/scheduler/) :daily_job.py(02:00) +backfill.py. - Utils (
src/utils/) : backups quotidiens, rétention 90 jours ;src/monitoring/pour la supervision. - anthropic SDK pour le KA Agent.
Processus PM2 sur le nœud :
| Processus | Rôle |
|---|---|
apika-api |
l'API FastAPI/Uvicorn sur le port 8000 (liée à 127.0.0.1) |
apika-scheduler |
le job quotidien 02:00 + backfill |
apika-ngrok |
tunnel ngrok vers www.api-ka.com |
Structure du repo
/opt/api-ka
├── src/          # api/ (routes, web, PDF), collectors/ (8), scheduler/, database/, monitoring/, utils/, config.py
├── scripts/      # deploy_m3u96b.sh, start_ngrok.sh…
├── systemd/      # unités historiques (le déploiement actuel utilise PM2)
├── tests/        # pytest
├── data/         # backups/YYYY-MM-DD/ (rétention 90 jours)
├── logs/         # logs centralisés + alerts.log
├── docs/         # captures d'écran
└── alembic.ini · pyproject.toml · requirements.txt · CLAUDE.mdDéveloppement (remote-first)
La source de vérité est le repo git sur le nœud M3U96b (/opt/api-ka) — on n'édite jamais les copies laptop. Toute modification se fait sur le nœud via SSH : édition, tests, pm2 restart, puis commit/push depuis le nœud.
- Remote
origin= spbgit (git perso git.spboucher.ai, bare repos sur M3U96a). Pas GitHub. - L'agent forwarding SSH est actif : le
git push origin mainfonctionne pendant une session SSH depuis le laptop. - Chaque fichier du dépôt porte l'en-tête d'auteur obligatoire (voir
CLAUDE.md).
python3 -m venv venv && source venv/bin/activate
pip install -r requirements.txt

python -m src.database.db --init                 # initialiser la base
uvicorn src.api.main:app --reload --port 8000    # API en dev
python -m src.scheduler.daily_job --now          # collecte manuelle immédiate
python -m src.scheduler.backfill --date 2026-08-15
pytest tests/ -v

pm2 restart apika-api # après un changement en productionDéploiement
- Nœud : M3U96b (Mac Studio, cluster MacLustr) — répertoire
/opt/api-ka(hostname vérifié au démarrage) - Port : 8000 (API liée à 127.0.0.1, exposée uniquement via le tunnel)
- Processus PM2 :
apika-api(API) +apika-scheduler(collectes) +apika-ngrok(tunnel) - Domaine : https://www.api-ka.com (tunnel ngrok)
Écosystème Groupe KA
- groupe-ka.com — portail du groupe et compte unique KA ID
- lou-ka.com — logements à louer
- immo-ka.com — propriétés à vendre
- vrai-prix.com — estimation immobilière
- auto-ka.com — véhicules
- fabri-ka.com — produits québécois
- food-ka.com — épicerie et alimentation
- resto-ka.com — restaurants
- sorti-ka.com — sorties et événements
- job-ka.com — emplois
- crea-ka.com — créateurs de contenu
- trouve-ka.com — petites annonces
- api-ka.com — API de données (ce repo)
© Groupe KA — Simon-Pierre Boucher · contact@spboucher.ai Ce repo vit sur spbgit (git.spboucher.ai).