Documentation · mise à jour 2026-08-24
Comment fonctionne API·Ka
L'API centrale du Groupe KA : collecte quotidienne des données des plateformes de l'écosystème, base PostgreSQL unifiée, API publique et KA Agent (IA).
Vue d'ensemble
À quoi sert le site
API·Ka (www.api-ka.com) est la plateforme de données centrale de l'écosystème Groupe KA. Chaque jour à 02:00, 8 collecteurs (lou-ka, immo-ka, food-ka, auto-ka, fabri-ka, resto-ka, sorti-ka, crea-ka) sauvegardent les données des plateformes dans une base PostgreSQL unifiée, puis les exposent via une API FastAPI publique : données paginées, historiques par date, statistiques, rapports PDF. Elle héberge aussi le KA Agent — l'assistant IA du groupe servi en widget aux 13 domaines — et sert de superviseur des connecteurs (historique des collectes, santé par service, alertes).
Guide pas à pas
Utiliser la plateforme en 3 étapes
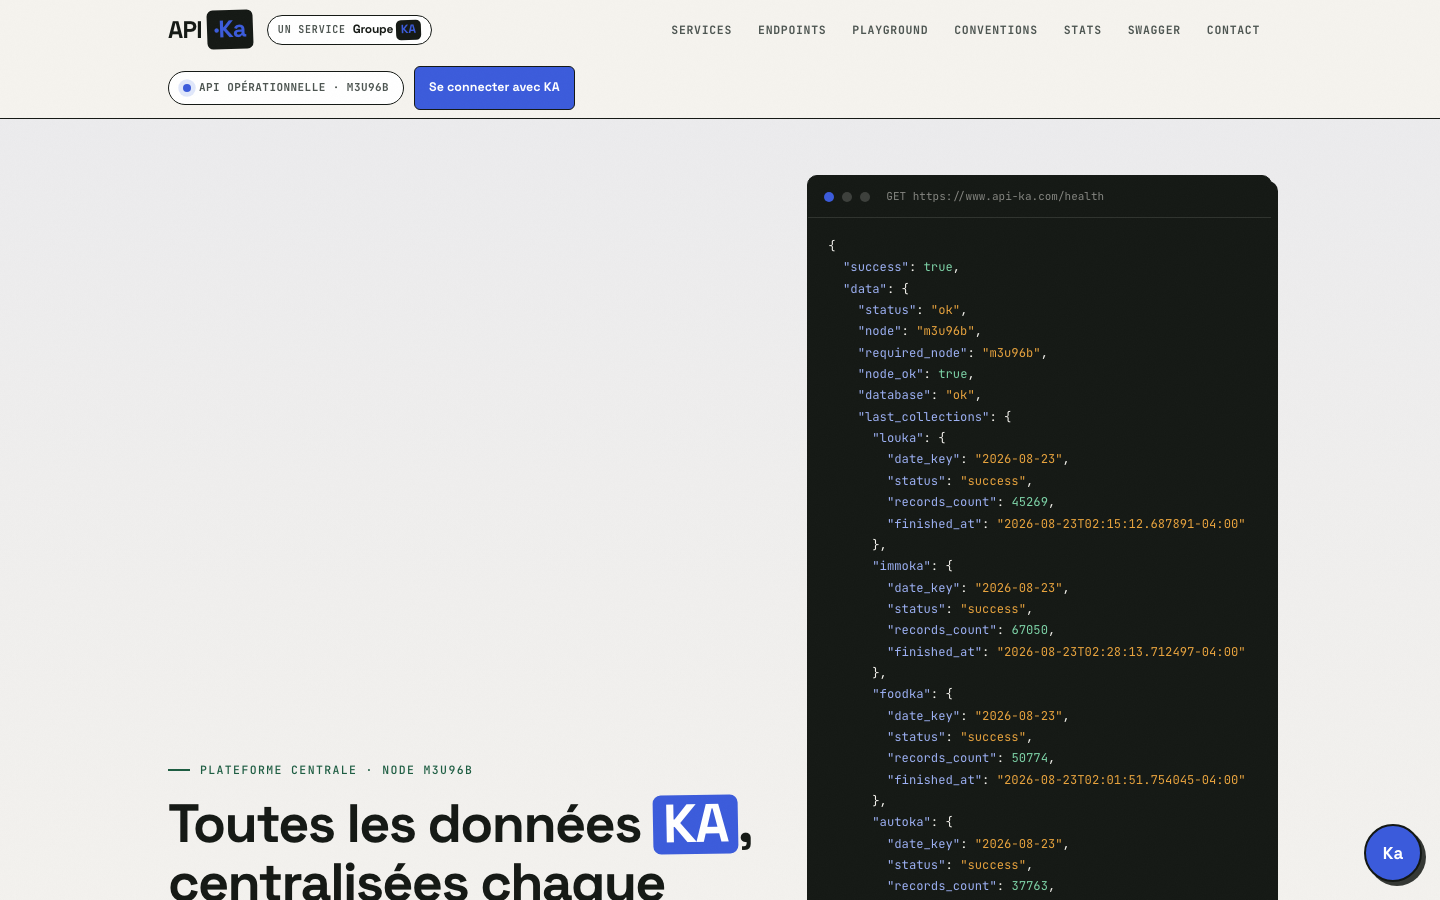
Explorez le site de documentation
L'accueil présente la plateforme, les 8 services collectés et un playground interactif pour tester les endpoints. Les clients API qui appellent la racine reçoivent le statut JSON ; les navigateurs reçoivent cette documentation.
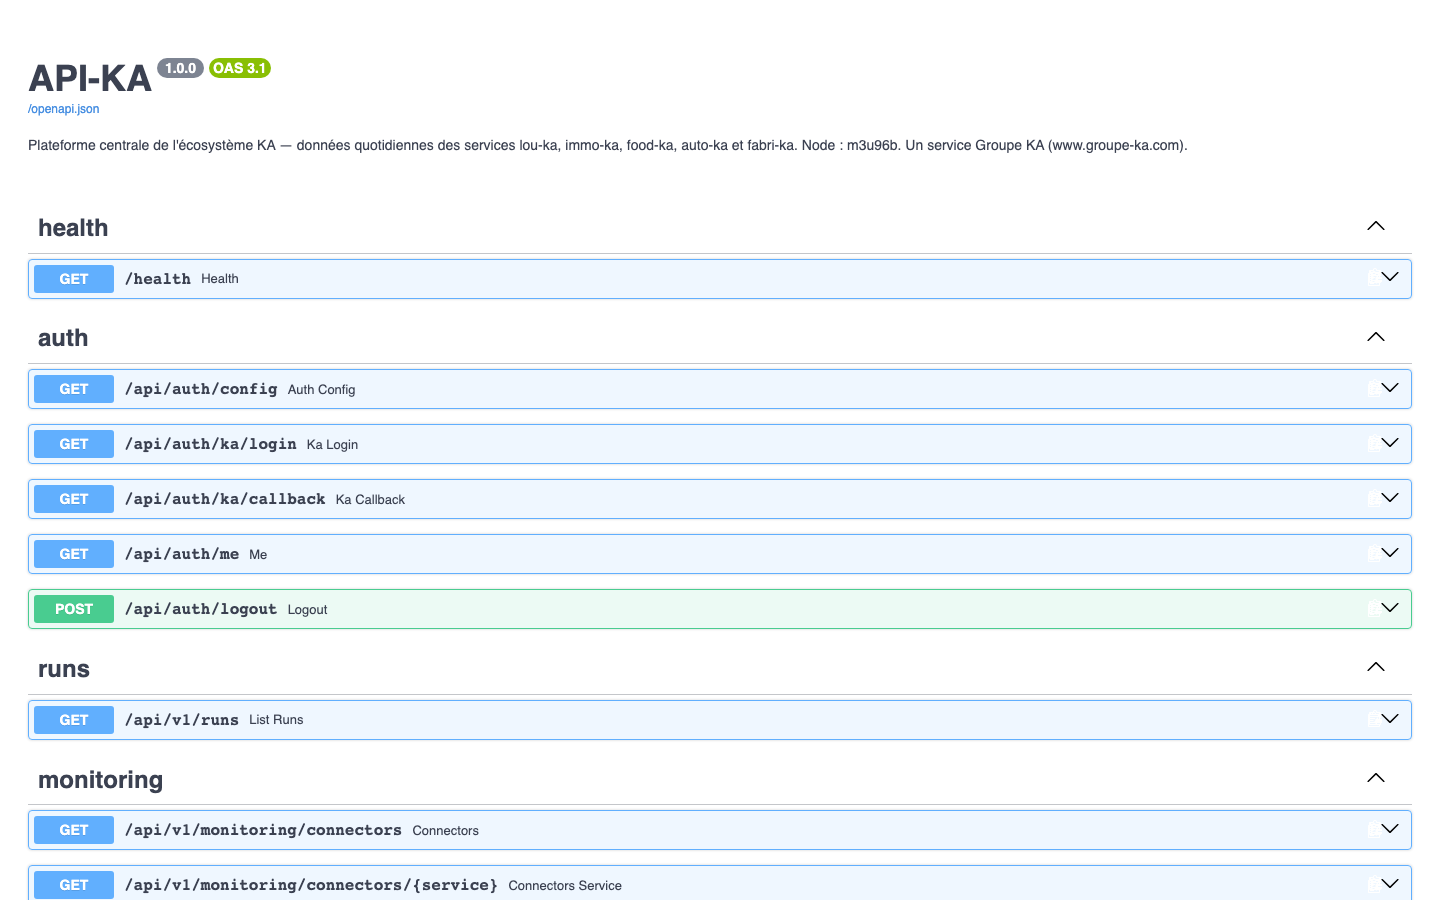
Parcourez l'API dans Swagger (/docs)
La référence interactive OpenAPI liste tous les endpoints : GET /api/v1/{service} (pagination, limite 500), /latest, /date/{YYYY-MM-DD}, /stats, /api/v1/runs (historique des collectes), /health… pour les services louka, immoka, foodka, autoka, fabrika, restoka, sortika et creaka. L'API produit exige une session KA ID ou un jeton Bearer kapi_ (généré sur groupe-ka.com/compte) ; monitoring, stats et agent restent ouverts.
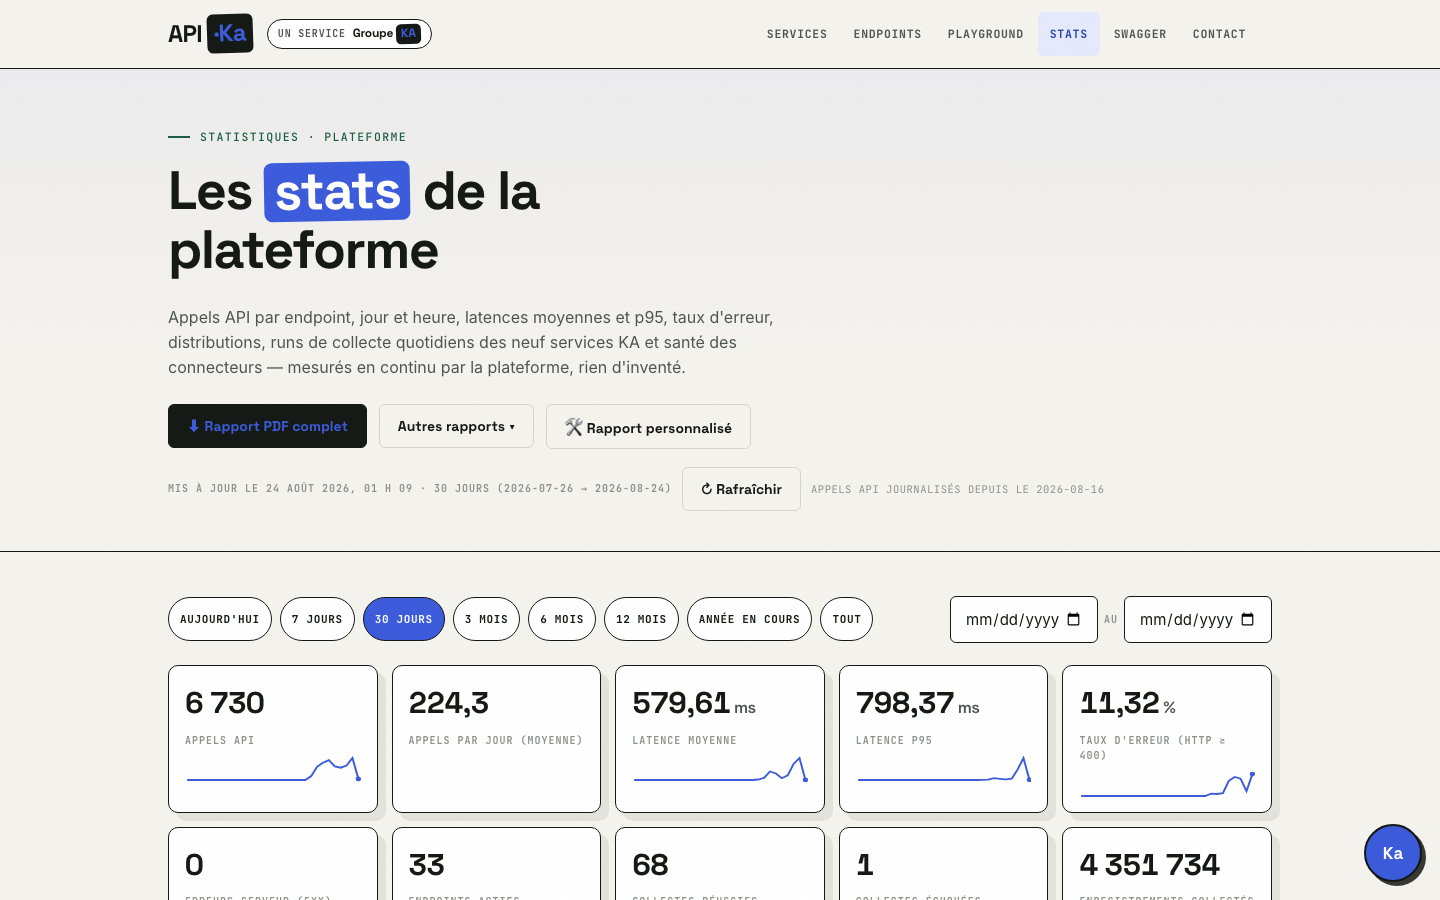
Surveillez les collectes sur /stats
Le tableau de bord montre l'état des collectes par service, les volumes et l'historique des runs ; les rapports PDF (plateforme et écosystème consolidé) se téléchargent depuis la même page.
Sous le capot
D'où viennent les données
Chaque collecteur hérite d'une classe de base commune : fetch → validation → checksum → insertion PostgreSQL →
backup → journal de run, avec retry 3× (backoff exponentiel 30 s → 2 min → 10 min) ; tout échec après 3 tentatives est
journalisé (collection_runs, alertes). Le scheduler APScheduler lance le job quotidien à 02:00 (collecteurs en parallèle
et indépendants) et un backfill automatique rattrape les dates manquées des 7 derniers jours. Les backups quotidiens sont
horodatés par service et conservés 90 jours. La base est PostgreSQL via SQLAlchemy 2 (migrations Alembic) : une table de
données par service plus le journal des collectes.
Questions fréquentes
FAQ
Créez un compte KA ID sur groupe-ka.com puis générez votre jeton personnel « kapi_ » sur la page /compte ; passez-le en en-tête Authorization: Bearer. Une session KA ID fonctionne aussi.
Le monitoring, les statistiques et le KA Agent. L'API produit (données des services) exige une session KA ID ou un jeton kapi_.
Une fois par jour à 02:00 (heure de l'Est), avec retry automatique et backfill des 7 derniers jours en cas de date manquée.
louka, immoka, foodka, autoka, fabrika, restoka, sortika et creaka — un collecteur et une table par service.
L'assistant IA central du groupe (Claude, streaming SSE, boucle d'outils branchés sur les API publiques des plateformes), servi en widget de chat aux 13 domaines de l'écosystème.