Documentation · mise à jour 2026-08-24
Comment fonctionne Trouve·Ka
Cherche le Québec. Un moteur de recherche web indépendant, Québec-first — son propre crawler, son propre index, son propre ranking, sans dépendre de Google, Bing ou Brave.
Vue d'ensemble
À quoi sert le site
Trouve·Ka est un vrai moteur de recherche québécois — pas un métamoteur : les résultats
viennent exclusivement de son propre index. Le crawler TrouveKABot découvre le web
québécois à partir de 64 seeds à forte autorité (gouvernement, municipalités, universités, médias),
suit les liens, juge la pertinence québécoise de chaque page et l'indexe immédiatement : une page
téléchargée est cherchable en 2 à 4 secondes. La recherche est bilingue (français/anglais, avec des
synonymes comme « thermopompe » ↔ « heat pump ») et couvre aussi les 13 autres plateformes du
Groupe KA — logements, propriétés, produits, restos, emplois, événements…
Guide pas à pas
Utiliser le site en 4 étapes
Tapez votre recherche sur l'accueil
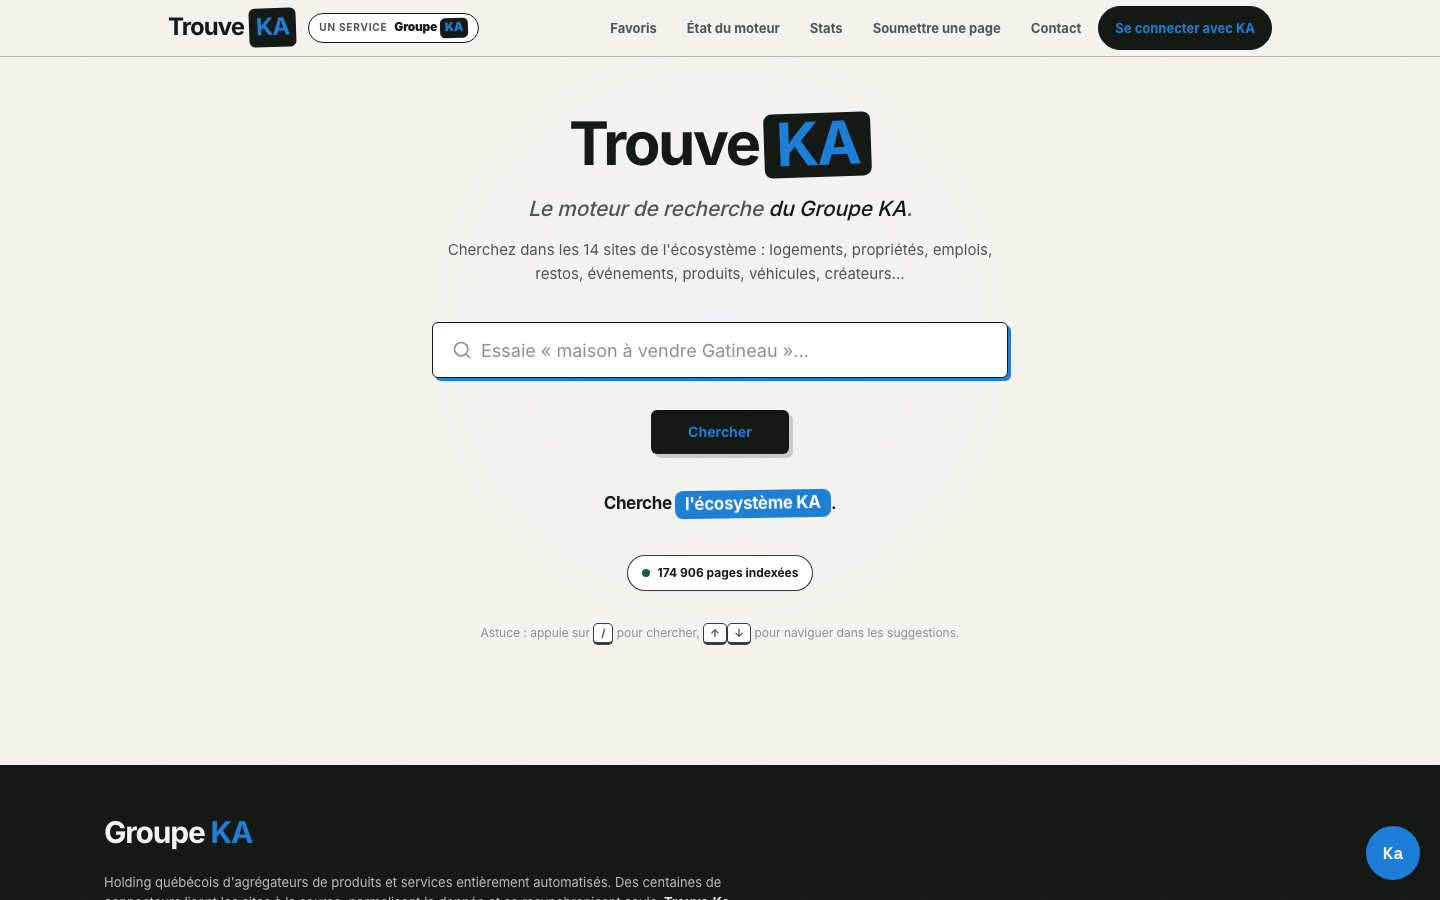
La page d'accueil va droit au but : une barre de recherche. Écrivez ce que vous cherchez en français ou en anglais — « cabane à sucre », « plombier Gatineau », « heat pump » — puis appuyez sur Chercher (ou Entrée).
Parcourez les résultats et affinez avec les filtres
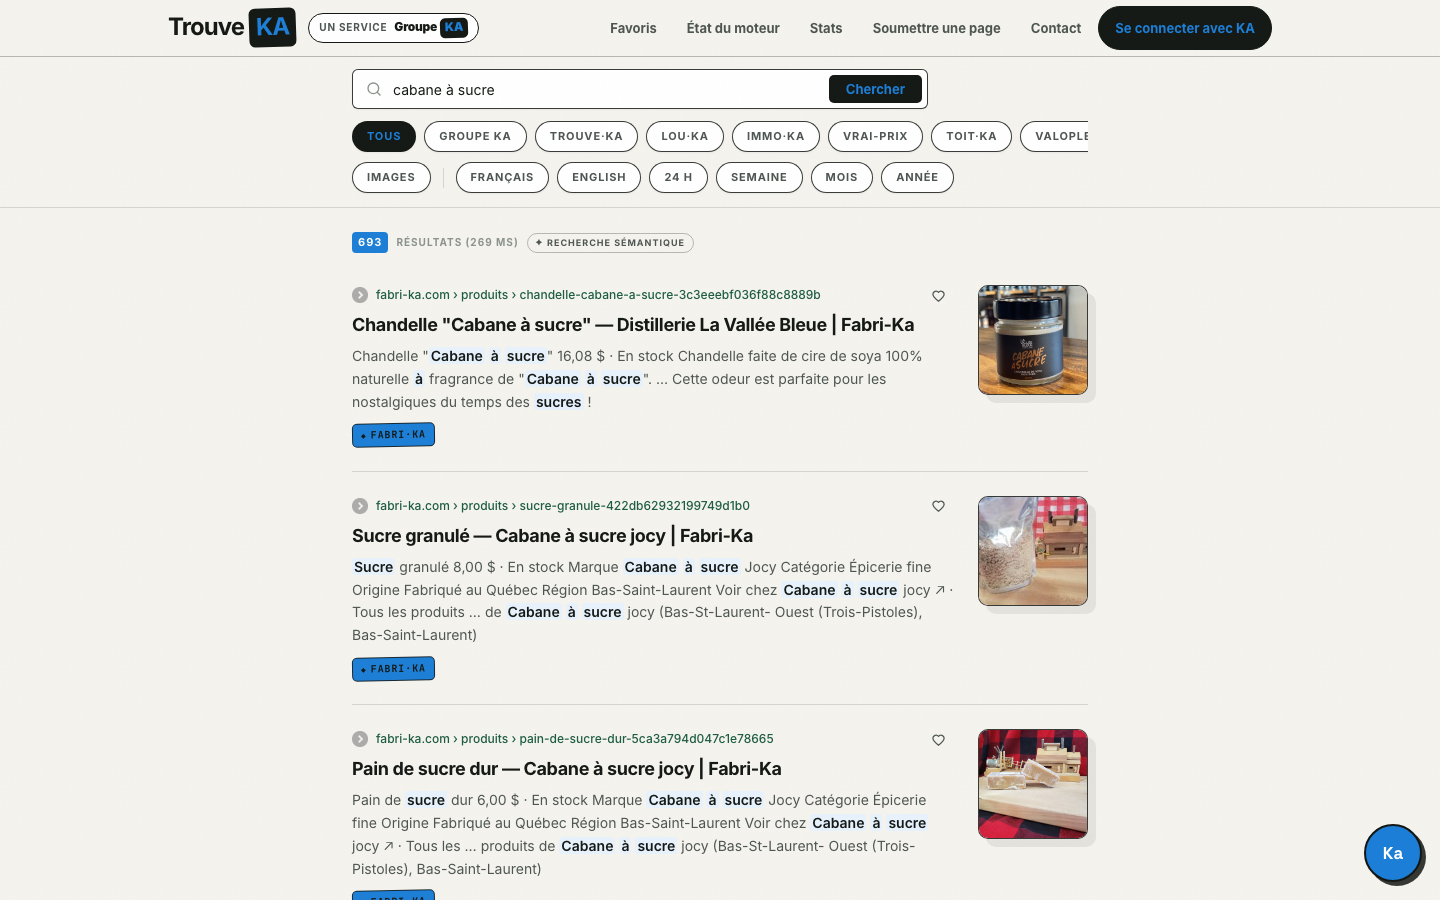
La page de résultats affiche le nombre de résultats et la latence réelle de la requête (souvent moins de 100 ms). Chaque résultat montre le fil d'Ariane du site source, un extrait avec vos mots surlignés et, s'il y a lieu, une image. Les pastilles sous la barre permettent de filtrer par site du Groupe KA (Lou·Ka, Immo·Ka, Fabri·Ka…), par langue (français/anglais) ou par fraîcheur (24 h, semaine, mois, année). Le bouton « + Recherche sémantique » élargit la recherche au sens des mots, pas seulement aux mots exacts.
Passez en mode Images
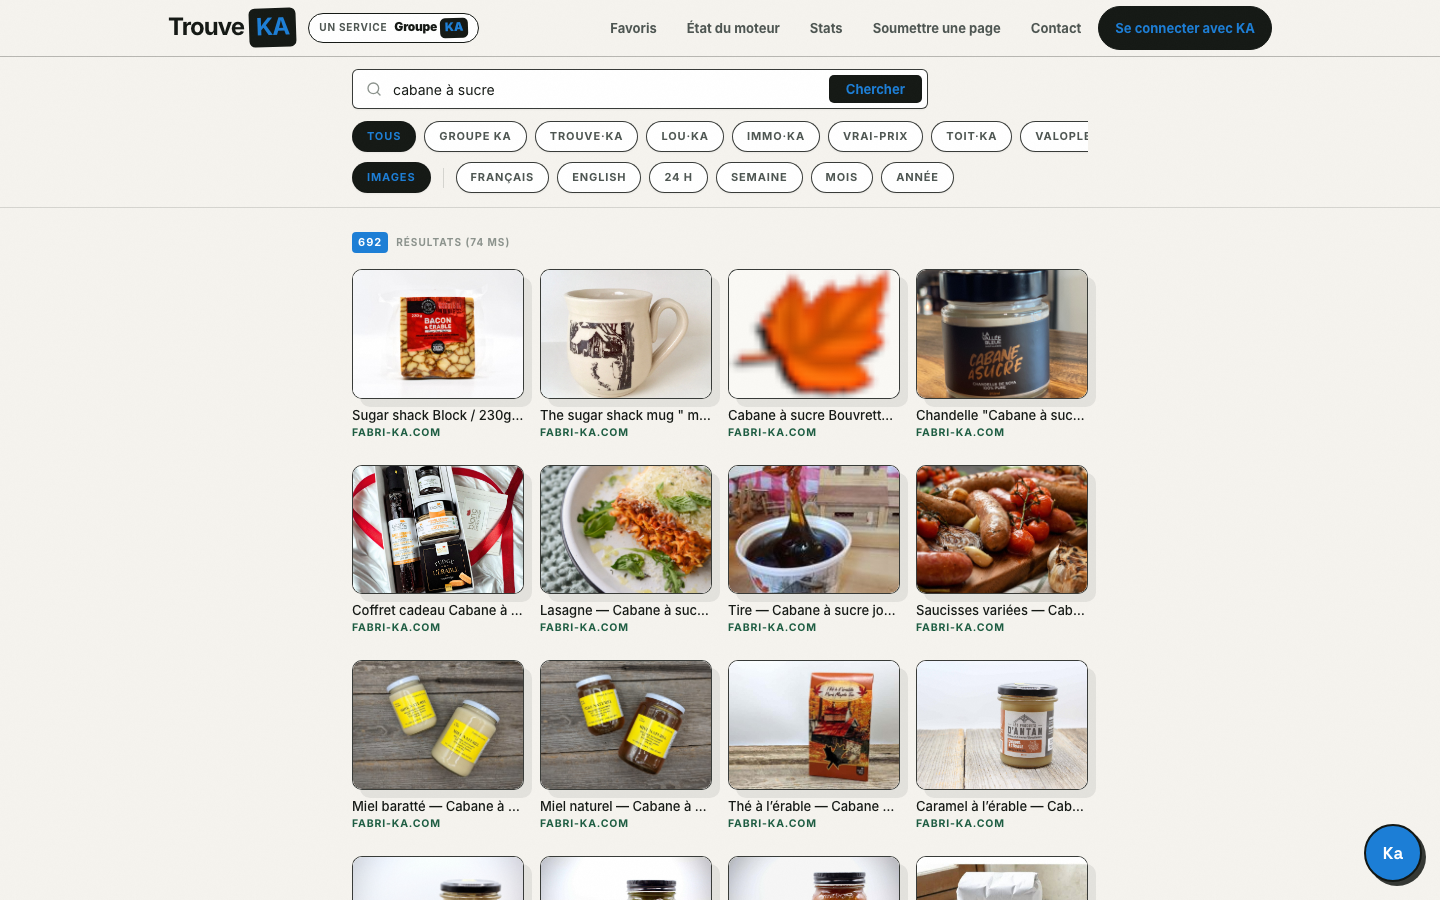
La pastille Images transforme les résultats en galerie : chaque vignette est l'image représentative d'une page indexée, avec son titre et son domaine source. Les images sont affichées depuis leur site d'origine avec attribution — Trouve·Ka ne crawle jamais les images elles-mêmes. Un clic ouvre la page d'origine.
Suivez le moteur en direct — et proposez vos pages
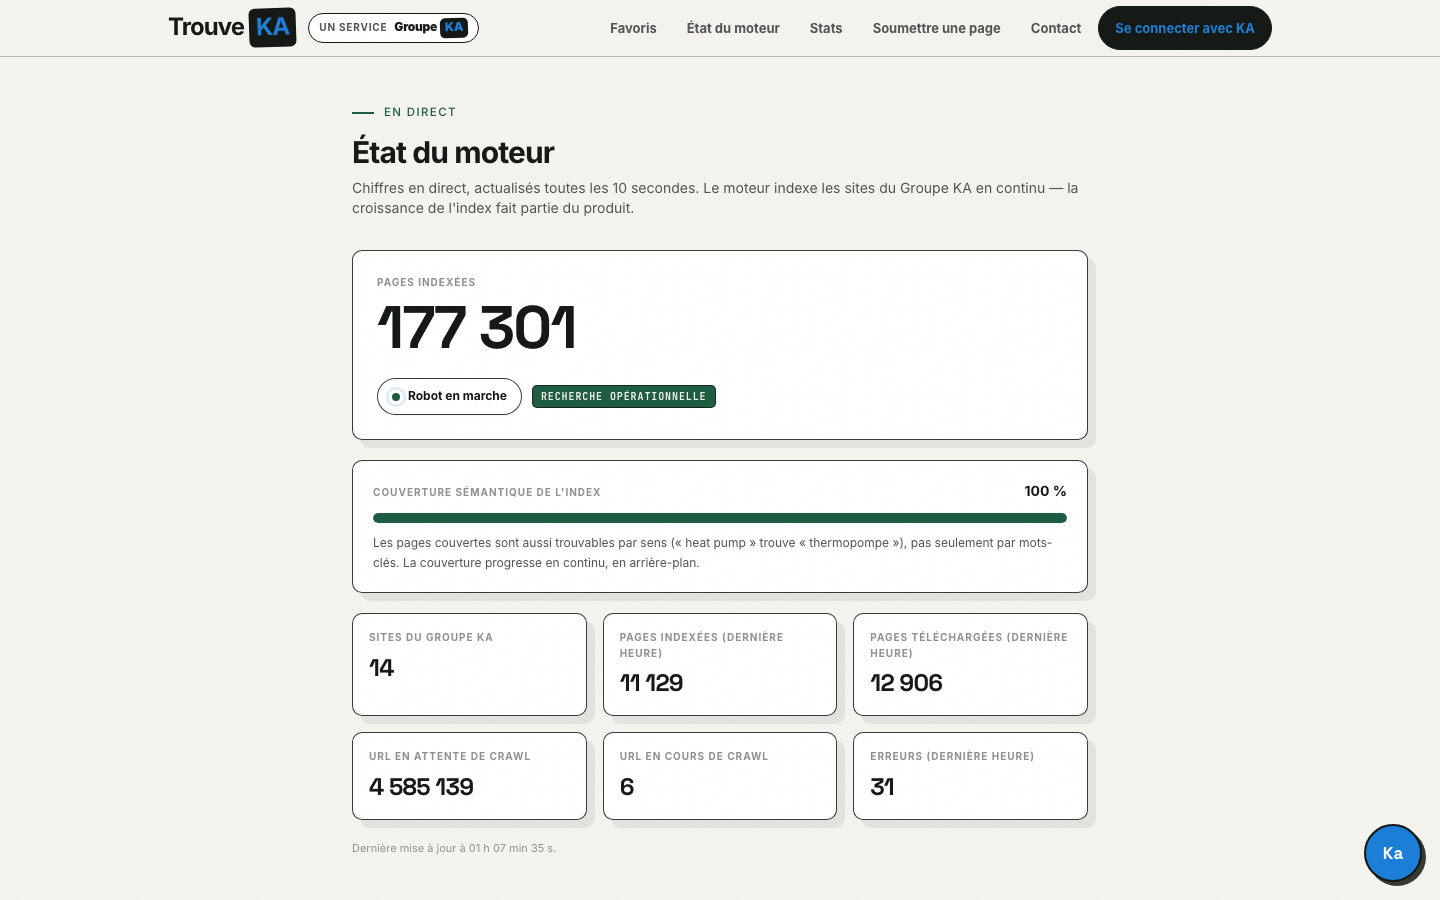
La page État du moteur montre les vrais chiffres, actualisés toutes les 10 secondes : pages indexées, pages téléchargées et indexées dans la dernière heure, URL en attente de crawl, couverture sémantique de l'index. Vous pouvez aussi soumettre une page à indexer, consulter les statistiques détaillées ou lire la page À propos du robot si vous administrez un site web.
Sous le capot
D'où viennent les données
Tout part du crawler maison. Le pipeline complet : Crawler → Frontier → Fetcher → Parser → Classification Québec → Déduplication → Indexer → Index → Ranking → API → Web App.
Le crawl démarre de 64 seeds à forte autorité (gouvernement, municipalités, universités,
médias) et suit les liens sortants ; il a ainsi découvert plus de 7 900 domaines québécois.
Chaque page reçoit un score de pertinence québécoise (page_quebec_score et
domain_quebec_score) calculé de façon déterministe — TLD .qc.ca/.quebec, toponymes,
codes postaux G/H/J, indicatifs 418/514/438…, organisations connues (Hydro-Québec, RAMQ, UQAM…),
JSON-LD, langue française — aucun modèle d'IA dans le chemin chaud. Les pages jugées pertinentes
sont indexées immédiatement dans OpenSearch (cherchables en 2–4 secondes), puis enrichies en
asynchrone : autorité de domaine, entités, embeddings pour la recherche sémantique — sans jamais
bloquer l'indexation.
Le classement des résultats combine la pertinence textuelle bilingue (BM25 FR/EN avec synonymes), les scores Québec, l'autorité du domaine, la fraîcheur de la page et un boost de localité (« plombier Gatineau » remonte les documents avec une preuve géographique). Le recrawl est adaptatif : une page qui ne change pas est revisitée moins souvent, une page volatile plus souvent.
Le robot est poli et assumé : identifié TrouveKABot avec sa page publique
/trouveka-bot, il respecte robots.txt et le
Crawl-delay, espace ses requêtes par hôte (2 s par défaut) et évite les pièges de
crawl (calendriers infinis, identifiants de session, facettes explosives).
Questions fréquentes
FAQ
robots.txt. Détails pour les webmestres :
/trouveka-bot.