
Trouve·Ka
Le moteur de recherche du Groupe KA — bâti au Québec, de zéro








Les pastilles de la deuxième rangée sont dynamiques : elles interrogent
/api/statusen direct — les chiffres que tu vois là-haut sont ceux du moteur en ce moment même.
Trouve·Ka est un vrai moteur de recherche — pas un métamoteur : aucune dépendance à Google, Bing ou Brave pour les résultats. Crawler, frontier, parseur, classification, index, ranking, sémantique : tout est maison. Né « moteur du web québécois ouvert » (64 seeds à forte autorité — gouvernement, municipalités, universités, médias — 7 898 domaines découverts), il a pivoté le 2026-08-23 pour devenir le moteur de recherche du Groupe KA : il indexe en continu les 14 sites de l'écosystème (logements, propriétés, emplois, restos, événements, produits, véhicules, créateurs, estimations…), alimenté par leurs sitemaps ingérés quotidiennement — le seul frontier dépasse les 4,6 M d'URL en attente. Chaque page fetchée est jugée (page_quebec_score, domain_quebec_score) et indexée immédiatement : cherchable en ~2–4 secondes. L'enrichissement (autorité, entités, embeddings, reranking) arrive après, en asynchrone, sans jamais bloquer — avec une couverture sémantique de 100 % de l'index.
Crawl en continu. Indexe immédiatement. Recherche immédiatement. Améliore en asynchrone.
Sitemaps KA + Seeds → Frontier → Fetcher → Parser → Classification Québec
→ Déduplication → Indexer → Index → Ranking (+ sémantique, rerank) → API → Web App
En production : https://www.trouve-ka.com — 302 000+ pages indexées (302 017 constatées sur /api/status le 24 août 2026 à 14 h 47, contre 181 369 le matin même : +120 000 pages dans la journée — la croissance de l'index fait partie du produit, la pastille dynamique ci-dessus fait foi). Détails techniques dans docs/architecture.md (diagrammes Mermaid) et docs/decisions.md ; guide utilisateur illustré sur /doc.
Chiffres live (instantané du 2026-08-24)
⚠️ Application archivée le 2026-09-04 — l'URL live (https://www.trouve-ka.com) est hors fonction ; l'app a été retirée du cluster MacLustr (registre mld, admin-ka, gardiens, site groupe-ka). Ce dépôt spbgit reste la source de vérité pour une remise en service. | Métrique | Valeur constatée | Source | |---|---|---| | Pages indexées | 302 017 (et ça monte — voir pastille dynamique) |
/api/status| | Sites du Groupe KA indexés | 14 |/api/status| | Pages indexées, dernière heure | 8 482 |/api/status| | Pages fetchées, dernière heure | 13 287 |/api/status| | Frontier (URL en attente) | 4 646 668 |/api/status| | Couverture sémantique | 100 % |/api/status| | Pages crawlées — 30 jours | 357 209 |/api/stats/dashboard| | Erreurs de crawl — 30 jours | 641 (~0,2 %) |/api/stats/dashboard| | Latence de recherche (sémantique + rerank actifs) | 258–425 ms sur 8 requêtes tests |/api/search(took_ms) | | Workers de crawl | 9, répartis sur 5 nœuds |pm2 ls+ satellites |
Visite guidée — le site en 10 captures
Captures du 2026-08-28, prises en production sur www.trouve-ka.com (desktop 1440×900, mobile 390×844).
1 · Accueil — la porte d'entrée du Groupe KA
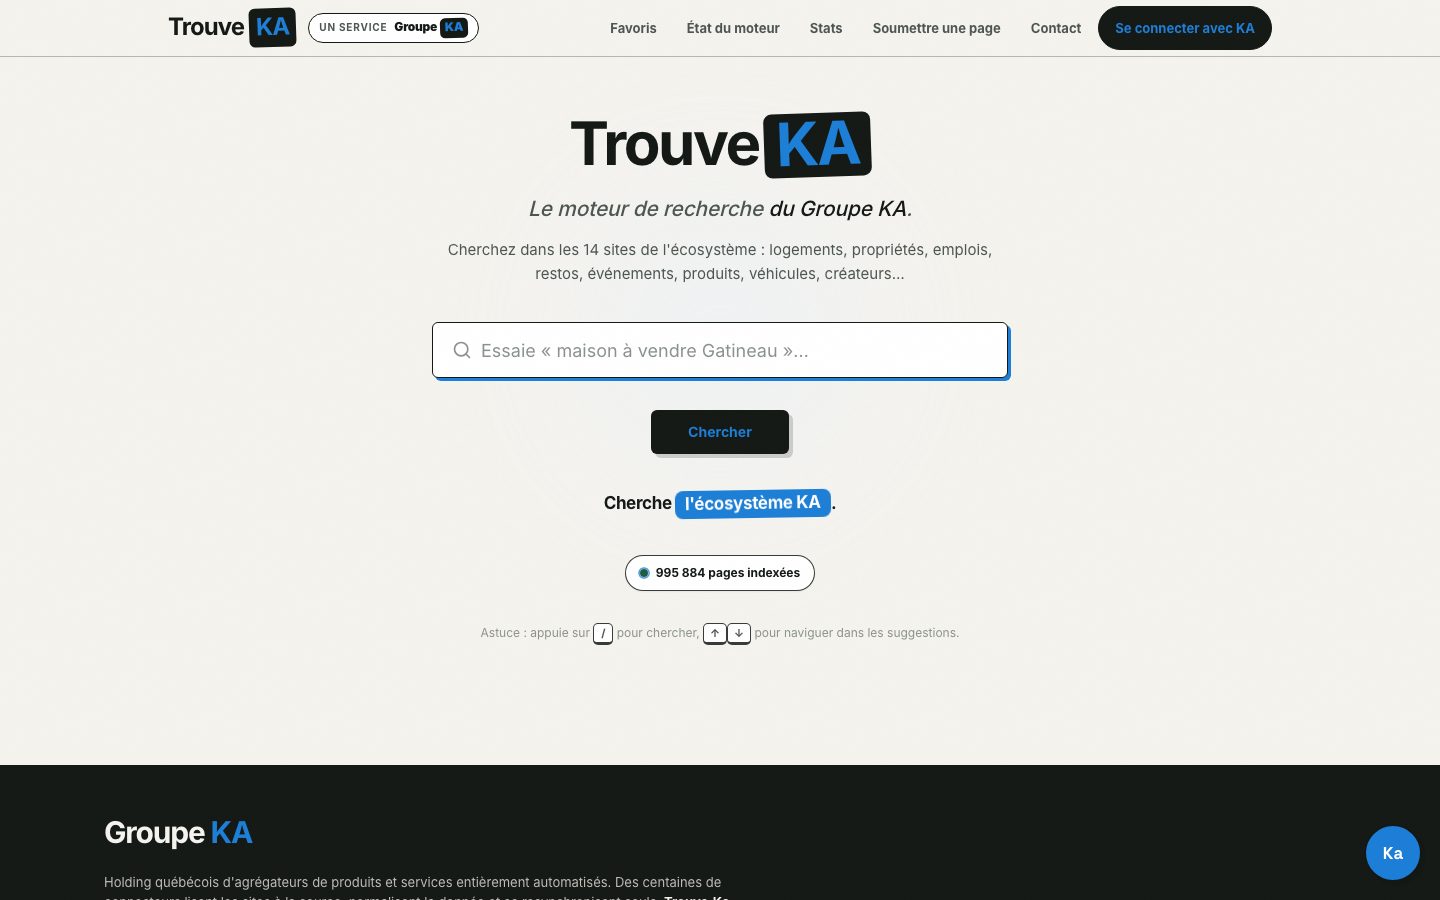
La page d'accueil (/) : une barre de recherche unique, sobre, avec suggestions à la saisie et compteur live de pages indexées — chaque visite affiche l'état réel du moteur, pas un chiffre figé. C'est le point d'entrée vers les 14 univers de l'écosystème : logements, propriétés, emplois, restos, événements, produits, véhicules, créateurs…
2 · L'accueil, suite — comprendre le moteur d'un coup d'œil
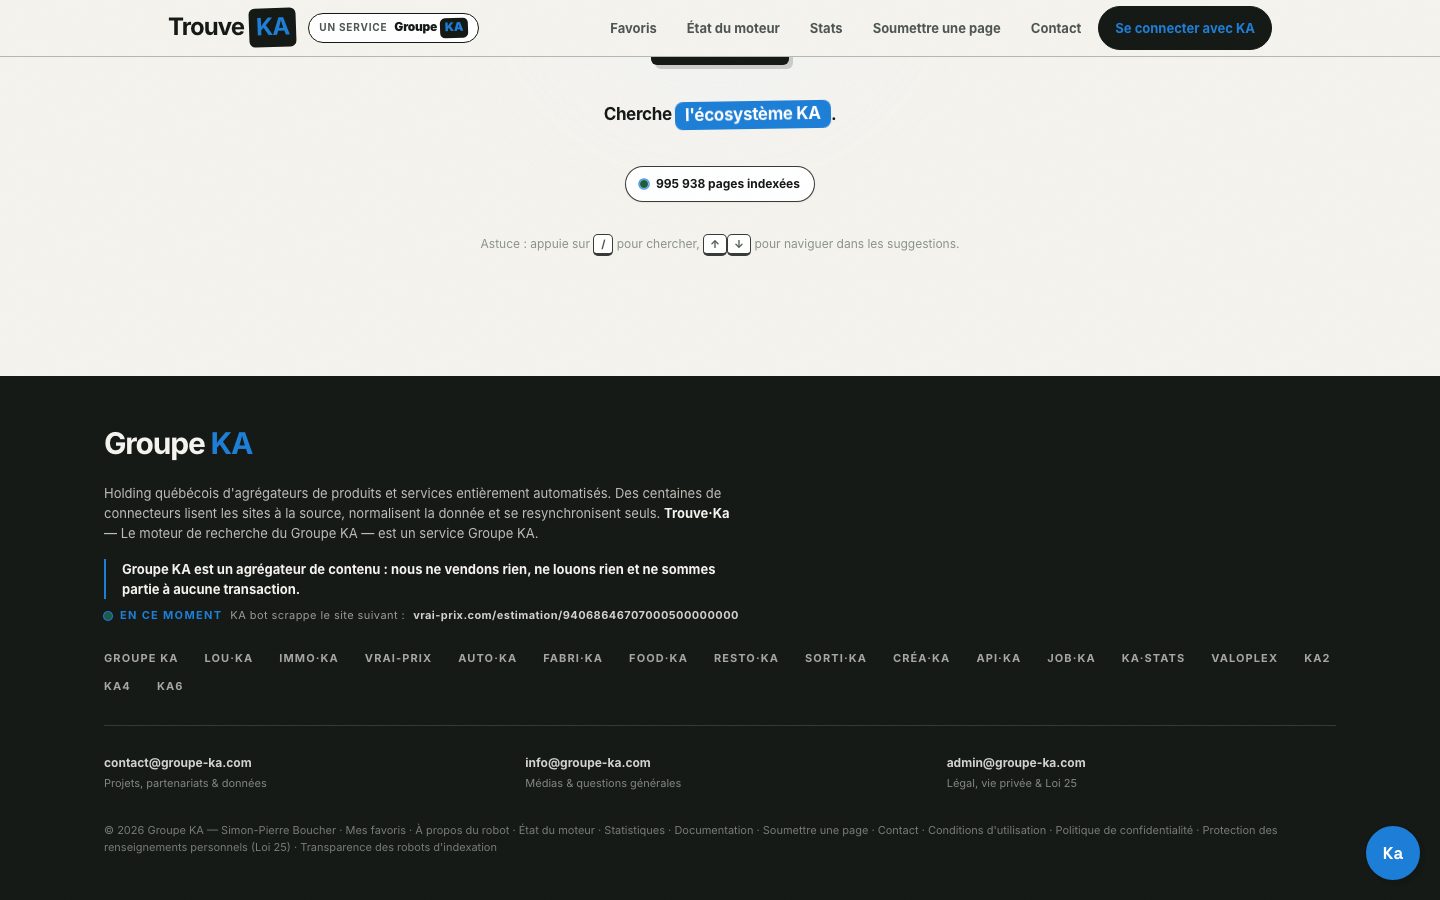
En défilant sous la barre de recherche, l'accueil explique le moteur : ce qu'il indexe (les sites du Groupe KA), comment il fonctionne (crawl continu, indexation immédiate, recherche sémantique) et les chiffres vivants de l'index. La transparence fait partie du produit.
3 · TrouveKABot — un robot qui se présente
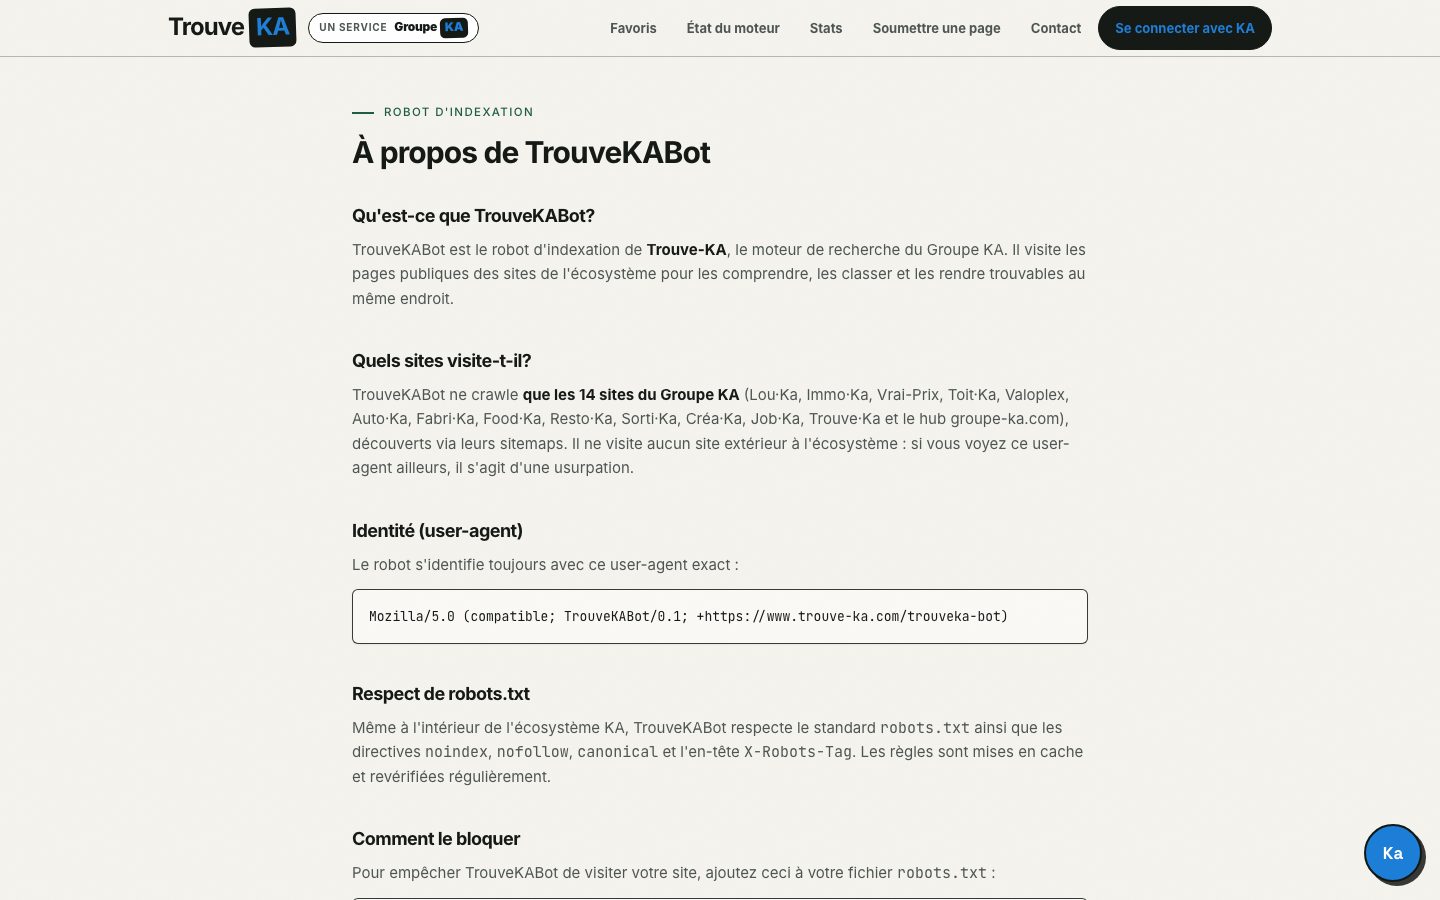
/trouveka-bot : la carte d'identité publique du crawler. Qui est TrouveKABot, quel User-Agent il envoie, comment il respecte robots.txt et Crawl-delay, comment le bloquer ou l'inviter. Un moteur de recherche assumé commence par un robot qui se présente.
4 · État du moteur — les entrailles en public
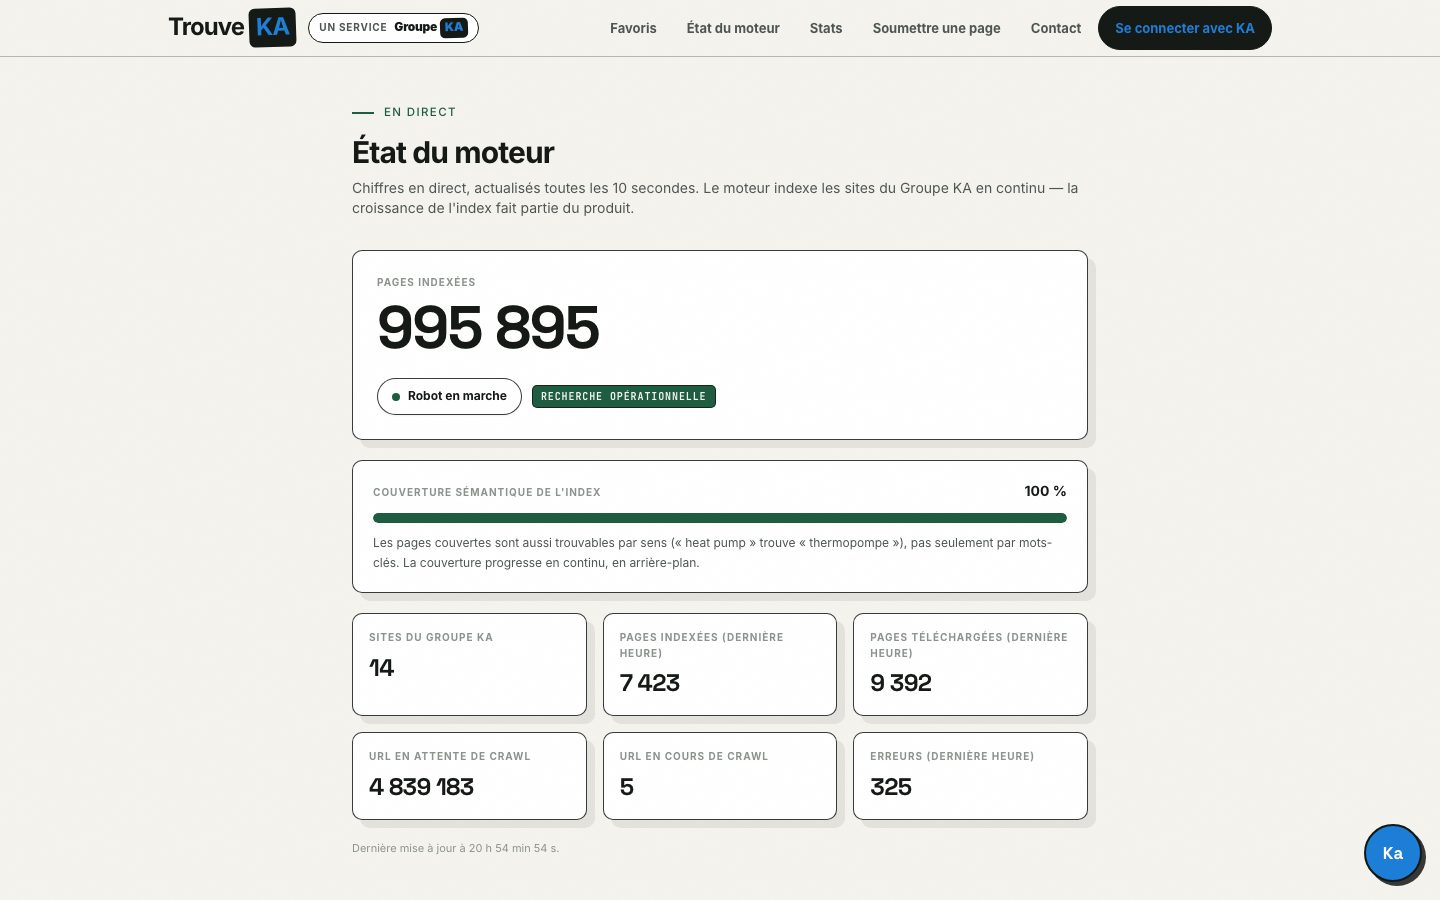
/status : pages indexées, sites KA couverts, pages fetchées/indexées dans la dernière heure, taille du frontier, état du crawler, couverture sémantique — rafraîchi toutes les 10 secondes, branché sur /api/status. Aucun compteur simulé : c'est une règle du projet.
5 · Statistiques — le tableau de bord public
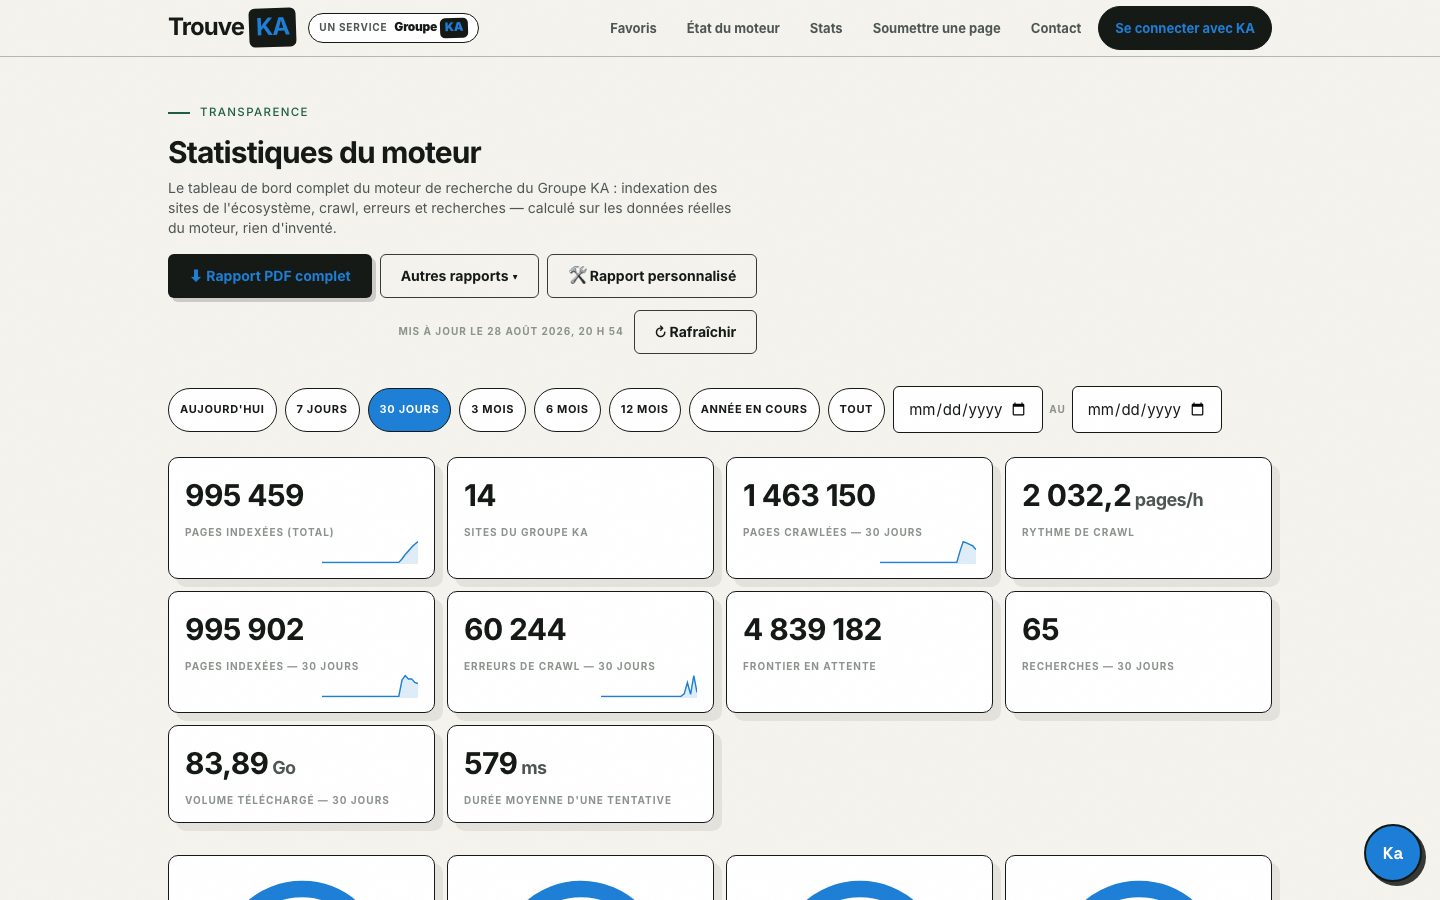
/stats : KPI, jauges et séries sur 30 jours (pages crawlées, erreurs, latences, répartition par univers), plus les rapports PDF Groupe KA — standard ou personnalisés bloc par bloc via le ReportBuilder (/api/stats/report, /api/stats/report/custom).
6 · Soumettre une page — inviter le crawler
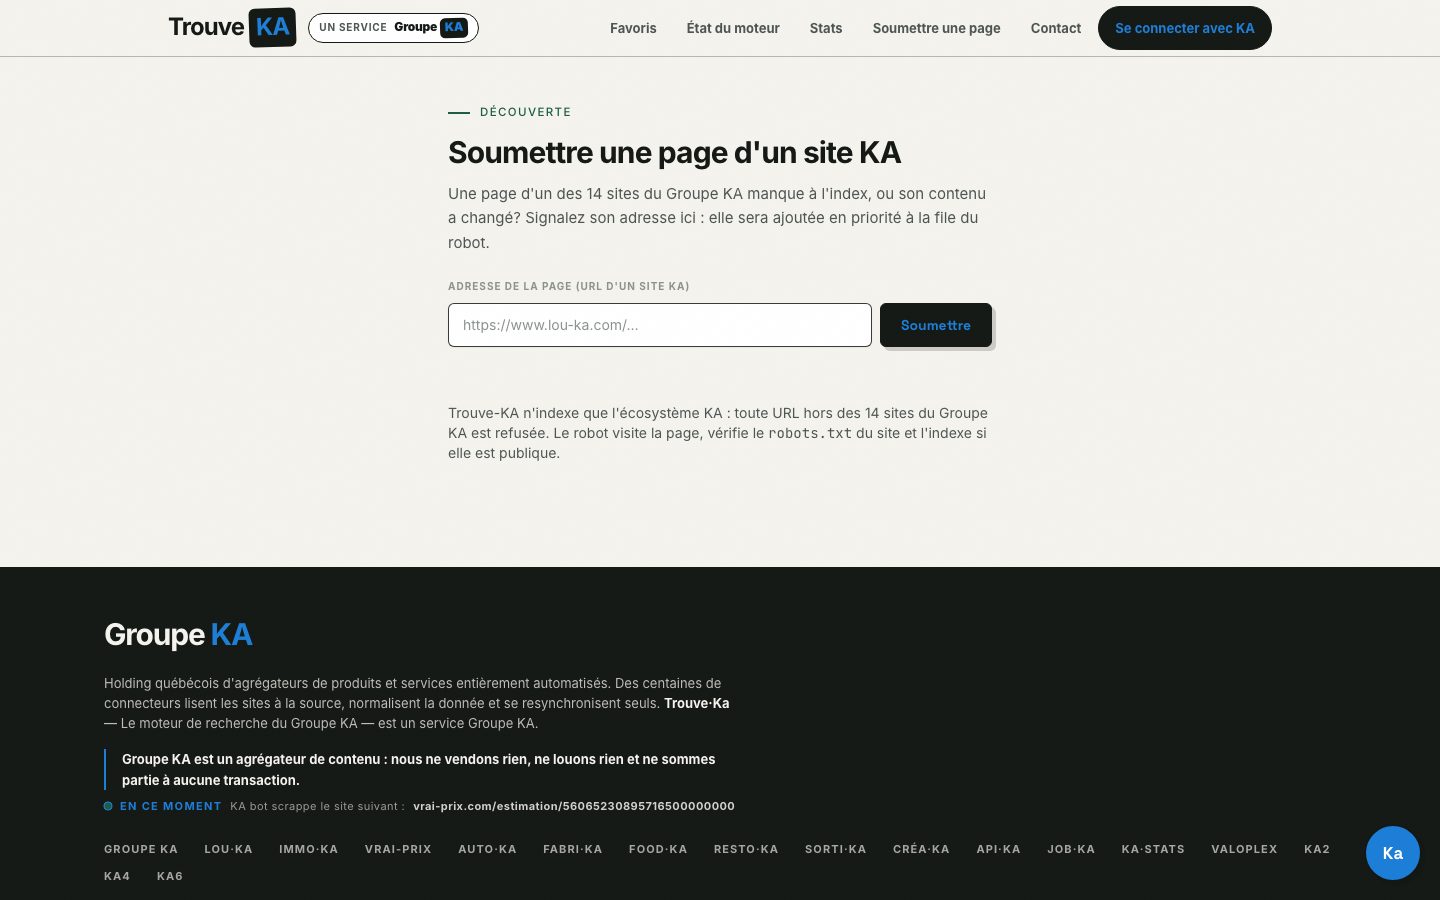
/soumettre : n'importe qui peut proposer une URL au crawl (POST /api/submit). L'URL passe par les mêmes gardes que tout le reste (robots.txt, SSRF, politesse) avant d'entrer au frontier — puis devient cherchable en quelques secondes une fois fetchée.
7 · Favoris — « Mon univers Ka » (KA ID)
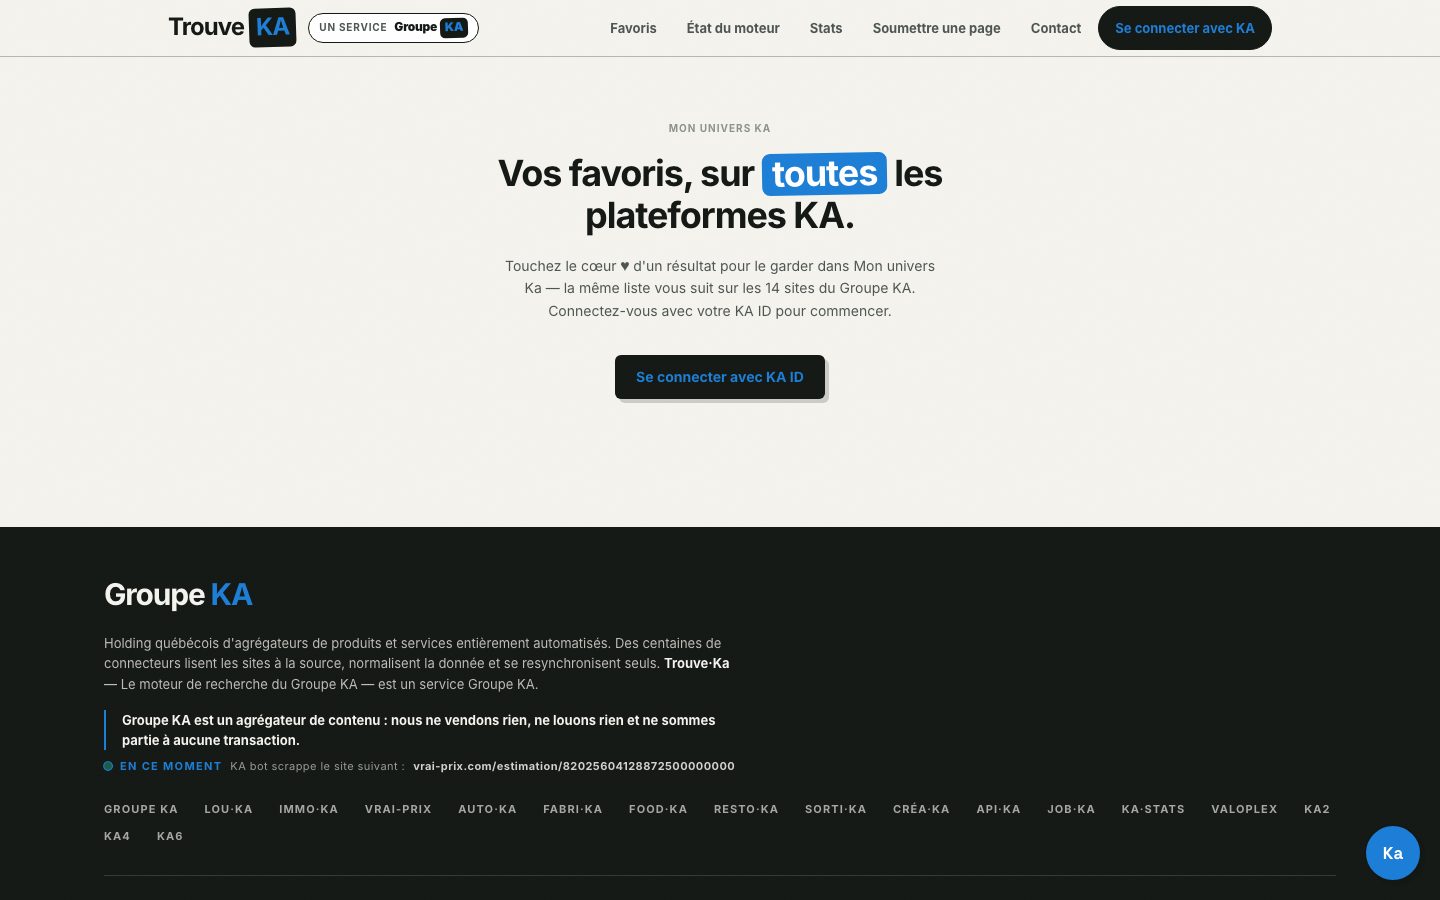
/favoris : connecté avec son KA ID (le SSO du Groupe KA), le membre retrouve ici ses favoris unifiés à travers les 12 sites de l'écosystème — un logement épinglé sur Lou-Ka, un resto sur Resto-Ka et un emploi sur Job-Ka vivent dans le même univers personnel.
8 · Documentation — le guide illustré
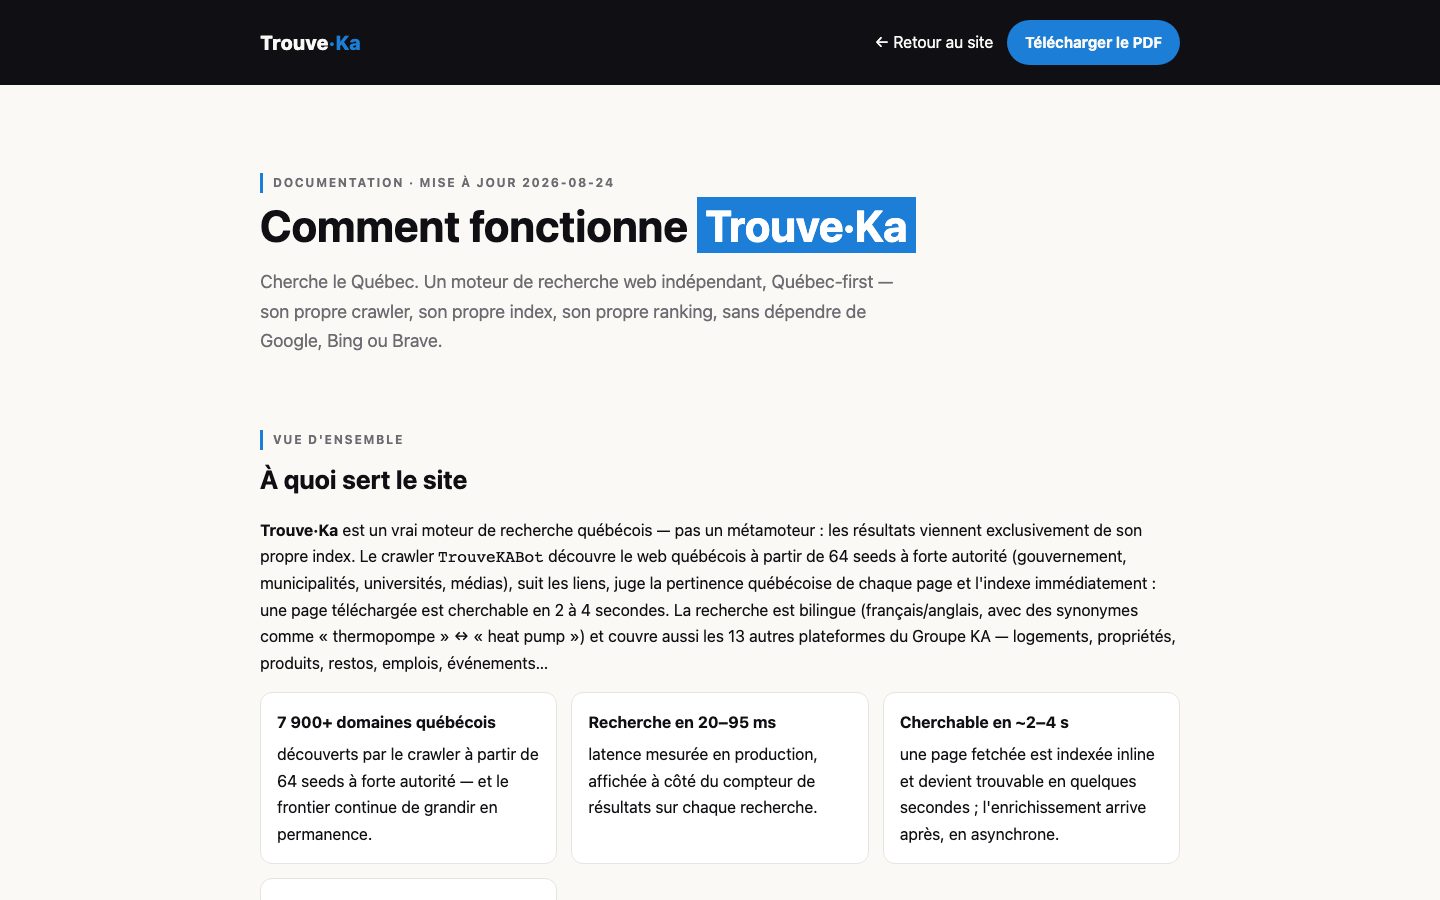
/doc : le guide utilisateur illustré (accueil, recherche, images, état du moteur, soumission), avec sa version PDF téléchargeable. La documentation publique est traitée comme une page du produit, pas comme une annexe.
9 · Contact
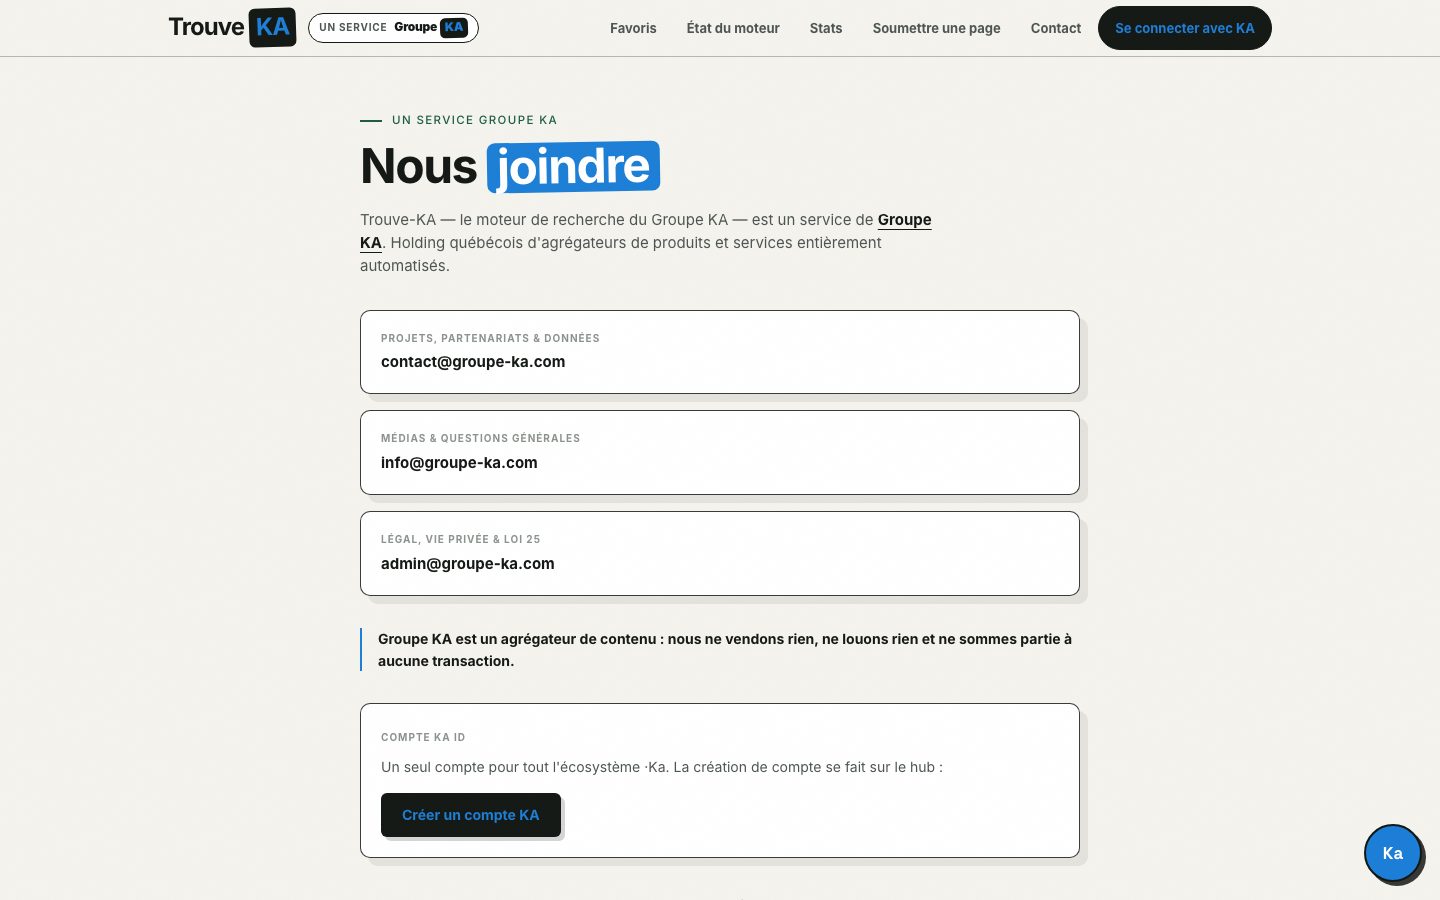
/contact : la page contact au design Groupe KA — pour joindre l'équipe, signaler un problème d'indexation ou demander un retrait.
10 · Mobile — le moteur dans la poche
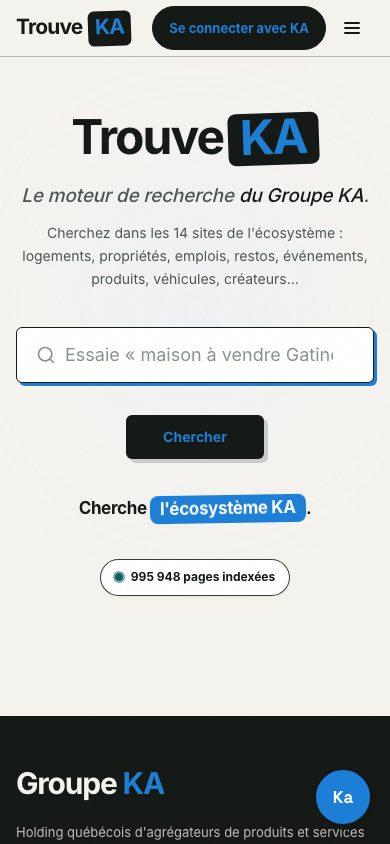
L'accueil en 390×844 : barre de recherche pleine largeur, navigation v2 en panneau plein écran, safe-areas et hauteurs dvh respectées — le standard mobile du Groupe KA (campagne 2026-08-19) appliqué au moteur.
🗄️ Les galeries WebP du 2026-08-25 (résultats de recherche, menu mobile, stats/status desktop) restent dans
docs/screenshots/mobile/etdocs/screenshots/desktop/; les captures d'époque sont conservées dansdocs/archive/et celles du guide public dansapps/web/public/doc/img/.
Nouveautés (2026-08)
- Moteur Groupe KA d'abord — index
tk-ka-pagesdédié aux 14 sites de l'écosystème, ingestion par sitemaps. - Favoris unifiés « Mon univers Ka » (KA ID).
- Nav mobile v2 — panneau plein écran avec fermeture interne.
- Widget ka-agent v4 — cartes de résultats cliquables (v4.2 : parseur ka-card tolérant, choix de clarification en boutons).
- KA ID v2 / v2.1 (2026-08-26) — journal des recherches vers le feature store KA ID (événement
searchsigné HMAC, session vérifiée côté API, best-effort) et reclassement personnalisé léger de la fenêtre de résultats (profil transversal du membre, blend 0.25, fail-open, champpersonalizeddans la réponse).
Fonctionnalités
- Moteur du Groupe KA : 302 000+ pages indexées (302 017 constatées live au 2026-08-24), 14 sites de l'écosystème indexés en continu, alimentés par ingestion quotidienne des sitemaps (
tk-sitemaps— vrai-prix déclare à lui seul ~3,75 M d'URL sur 84 chunks, traités en streaming) ; 4,6 M d'URL au frontier. - Indexation incrémentale : fetch → parse → score → index inline (
refresh_interval: 1scôté OpenSearch) → cherchable en secondes. Détection de changement par hash de contenu + ETag/If-Modified-Since, recrawl adaptatif (inchangé → intervalle ×2, volatil → ÷2). - Détection Québec déterministe : TLD (.qc.ca, .quebec), gazetteer de toponymes, codes postaux G/H/J, indicatifs (418/514/438/…), organisations connues (Hydro-Québec, RAMQ, UQAM…), JSON-LD, langue française — aucun LLM dans le chemin chaud. Héritée de la phase « web ouvert », toujours active (
ka_only=Falsedans la config restaure le comportement web québécois ouvert — le pivot est réversible). - Ranking bilingue :
function_scoreOpenSearch — BM25 FR/EN avec synonymes bilingues (thermopompe ↔ heat pump) + scores Québec + autorité de domaine (inlinks pondérés) + fraîcheur + boost de localité (« plombier Gatineau » → documents avec preuve géographique). - Recherche sémantique + reranking : embeddings sur 100 % de l'index — « heat pump » trouve « thermopompe », pas seulement par mots-clés — et un reranker réordonne les meilleurs résultats (service dédié sur le nœud m4mc). Latence mesurée au 2026-08-24 : 258–425 ms avec sémantique + rerank actifs sur toutes les requêtes tests ; le chemin lexical pur descendait à 20–95 ms (captures de la phase web ouvert).
- Crawler poli et assumé : UA identifié
TrouveKABot, page publique /trouveka-bot, robots.txt respecté (Protego, cache 24 h), verrou de politesse Redis par hôte (défaut 2 s,Crawl-delayhonoré), garde SSRF (IP privées/loopback/métadonnées cloud bloquées, revalidée à chaque redirection), détection de pièges de crawl (session IDs, calendriers infinis, facettes explosives). - Onglet Images : galerie des pages avec image représentative (hotlink + attribution, jamais de crawl d'images).
- Métriques publiques réelles :
/statuset/stats(tableau de bord + rapports PDF Groupe KA personnalisables) — aucun compteur simulé, c'est une règle du projet. Les chiffres se rafraîchissent toutes les 10 secondes — et les pastilles de ce README interrogent la même API. - Crawl distribué multi-nœuds auto-guéri : 9 workers sur 5 nœuds (2 sur le hub M2M32, 3 sur M2M32c, 2 sur M4BP48, 1 sur M1M32, 1 sur m4ma), coordonnés sans orchestrateur via le frontier Postgres (
FOR UPDATE SKIP LOCKED) et les verrous Redis. Tout le trafic inter-nœuds passe par des tunnels SSH sur 127.0.0.1 (contournement du filtre « réseau local » de macOS 26, qui bloque les binaires non signés). Watchdog toutes les 2 min, passe de flotte ~30 min, survie au reboot prouvée (API tuée → ressuscitée en 40 s ; reboot complet de m4ma → tunnels + worker revenus seuls). - SSO KA ID + favoris « Mon univers Ka », design Groupe KA, SEO complet (canonical, JSON-LD WebSite/SearchAction/Organization, sitemap) et widget KA Agent (bulle de chat IA déplaçable, cartes de résultats cliquables depuis v4).
- Personnalisation KA ID (opt-in, fail-open) : pour un membre connecté, les recherches alimentent le feature store du hub KA ID (événement signé HMAC, best-effort) et un reclassement personnalisé léger réordonne la fenêtre de résultats selon le profil transversal du membre (blend 0.25) — jamais bloquant, la réponse expose le champ
personalized.
Pipeline complet
Le chemin d'une page, de sa découverte à sa présence dans les résultats :
- Découverte — le frontier (Postgres) est alimenté par les 14 seeds (les pages d'accueil des sites KA,
scripts/bootstrap-seeds/seeds.txt) et surtout par l'ingestion quotidienne des sitemaps des sites du Groupe KA (scripts/ka-sitemaps/ingest.py, process PM2tk-sitemaps) : découverte via robots.txt (Sitemap:), suivi des index de sitemaps, traitement en streaming chunk par chunk, priorité aux pages peu profondes (accueil, villes, catégories) avant les fiches. 4,6 M+ d'URL en attente en prod. Les workers se servent sans orchestrateur viaFOR UPDATE SKIP LOCKED. - Fetch poli —
TrouveKABotprend un verrou de politesse Redis par hôte (2 s par défaut,Crawl-delayhonoré), vérifie robots.txt (Protego, cache 24 h) et la garde SSRF, puis télécharge avec ETag/If-Modified-Since. - Parsing — extraction du contenu principal, du titre, des métadonnées, du JSON-LD, des liens sortants et d'une image représentative (selectolax).
- Classification Québec — calcul déterministe de
page_quebec_scoreetdomain_quebec_score(TLD, toponymes, codes postaux, indicatifs, organisations, langue) — aucun LLM dans le chemin chaud. - Déduplication + indexation inline — hash de contenu, puis indexation immédiate dans OpenSearch 2.17 (
refresh_interval: 1s) : la page est cherchable en ~2–4 s. - Enrichissement asynchrone — via Redis Streams : autorité de domaine (inlinks pondérés), entités, embeddings sémantiques. Ne bloque jamais l'indexation ; en panne, le lexical continue.
- Recrawl adaptatif — le scheduler recale l'intervalle de revisite : contenu inchangé → intervalle ×2, contenu volatil → ÷2.
- Ranking —
function_score: BM25 FR/EN + synonymes bilingues + scores Québec + autorité + fraîcheur + boost de localité, avec réécriture sémantique et reranking quand ils aident.
API
L'API FastAPI (trouveka.api) est servie derrière le proxy Next.js (/api/*) — un seul port exposé (3000). Toutes les routes ci-dessous sont celles du code (@app.get/post), vérifiées au 2026-08-24 :
| Endpoint | Méthode | Rôle |
|---|---|---|
/api/search |
GET | Recherche principale — requête, filtres univers KA/langue/fraîcheur, onglet images ; renvoie total, took_ms, semantic, reranked, related, personalized (reclassement KA ID) |
/api/suggest |
GET | Suggestions de saisie (autocomplete) |
/api/status |
GET | État du moteur en JSON : pages_indexed, domains_count, indexed_last_hour, fetched_last_hour, errors_last_hour, frontier_pending, frontier_in_progress, crawler_state, search_ok, embedding_coverage |
/api/live |
GET | Flux « en ce moment » — la page en cours de crawl (url, domaine, issue) |
/api/submit |
POST | Soumission publique d'une URL au crawl (/soumettre) |
/api/health |
GET | Sonde de santé ({"ok": true, "search_ok": true}) |
/api/stats/dashboard |
GET | KPI, jauges, séries 30 jours du tableau de bord /stats |
/api/stats/catalog |
GET | Catalogue des blocs disponibles pour les rapports |
/api/stats/report |
GET | Rapport PDF Groupe KA standard |
/api/stats/report/custom |
POST | Rapport PDF personnalisé (ReportBuilder — blocs et rendus au choix) |
/api/admin/overview · /recent · /frontier · /zero-results |
GET | Exploitation : vue d'ensemble, derniers crawls, état du frontier, requêtes sans résultat — protégés par X-Admin-Token |
/api/admin/pause · /resume · /recrawl · /seeds · /domains/block |
POST | Exploitation : pause/reprise du crawl, recrawl forcé, ajout de seeds, blocage de domaine — protégés par X-Admin-Token |
/embed · /rerank |
POST | Service d'embeddings + reranker interne (nœud m4mc, services/embedding) — jamais exposé publiquement |
Latences observées en prod (2026-08-24) : 258–425 ms avec recherche sémantique + reranking actifs (345 ms « poutine » · 4 395 résultats, 258 ms « resto québec » · 2 959 résultats, 425 ms « cabane à sucre » · 1 131 résultats). Le chemin lexical pur mesurait 20–95 ms (21 ms « plombier gatineau », 29 ms onglet Images — captures de la phase web ouvert).
Architecture
Le moteur tourne en architecture native distribuée sur 7 nœuds du cluster MacLustr, coordonnée sans orchestrateur. Hub M2M32 (Mac Studio, 12 cœurs, 32 Go) : processus natifs sous PM2, données en Docker ; l'index et la sémantique vivent sur des nœuds dédiés, reliés par tunnels SSH.
Processus PM2 sur M2M32 (commandes réelles)
| Processus | Commande | Rôle |
|---|---|---|
| tk-web | pnpm start (cwd apps/web) |
Web public Next.js 15 (port 3000) — proxifie /api/* vers l'API interne ; un seul port exposé |
| tk-api | .venv/bin/python -m uvicorn trouveka.api.main:app --host 0.0.0.0 --port 8080 |
API FastAPI — recherche, statut, stats, soumission, admin (X-Admin-Token) |
| tk-crawler-1 / tk-crawler-2 | .venv/bin/python -m trouveka.crawler.worker |
Workers de crawl du hub : fetch → parse → score → indexation inline |
| tk-enrichment | .venv/bin/python -m trouveka.enrichment.worker |
Enrichissement asynchrone (autorité, entités, embeddings) via Redis Streams |
| tk-scheduler | .venv/bin/python -m trouveka.scheduler.loop |
Recrawls adaptatifs, entretien du frontier, rétention des données |
| tk-sitemaps | scripts/ka-sitemaps/ingest.py |
Ingestion quotidienne des sitemaps des 14 sites KA (streaming, priorités) — s'arrête entre deux passes |
| tk-tun-search | ssh -N -L 127.0.0.1:9210:localhost:9200 …@192.168.2.77 |
Tunnel vers OpenSearch (M2M32b) |
| tk-tun-embed | ssh -N -L 127.0.0.1:8191:localhost:8091 …@192.168.2.75 |
Tunnel vers embeddings + reranker (m4mc) |
Répartition sur le cluster
| Nœud | Rôle |
|---|---|
| M2M32 (hub) | PM2 ci-dessus + postgres:16-alpine et redis:7-alpine en Docker (frontier, domaines, documents, graphe de liens, analytics ; verrous de politesse, pause, Redis Streams) + tunnel ngrok (launchd com.trouveka.ngrok, ngrok http --url=www.trouve-ka.com 3000) |
| M2M32b | OpenSearch 2.17 en Docker (trouveka-opensearch, heap 8 G) — l'index, BM25 FR/EN + function_score Québec-first |
| m4mc | Service embeddings + reranker (services/embedding, venv dédié avec torch, port 8091) |
| M2M32c (×3), M4BP48 (×2), M1M32, m4ma | Workers de crawl satellites (trouveka.crawler.worker) — se connectent à Postgres/Redis (192.168.2.90) et OpenSearch (192.168.2.77) par tunnels SSH bouclés (trouveka-tunloop-*) |
Postgres est réglé pour cette flotte (max_connections=200, keepalives TCP, idle_in_transaction_session_timeout — un satellite tué net ne tient plus de verrous zombies). Auto-guérison : io.trouveka.boot (launchd, tous les nœuds), io.trouveka.watchdog (M2M32, toutes les 2 min), passe de flotte ~30 min, backups quotidiens croisés Postgres + OpenSearch (03:30–04:40). Dégradation gracieuse partout : embeddings en panne → le lexical continue ; un worker crash → le frontier continue.
Démarrage rapide (dev local)
# 1. Infrastructure de données (Postgres 16 + Redis 7 + OpenSearch 2.17.1)
docker compose up -d postgres redis opensearch

# 2. Backend Python (>= 3.12, package namespace trouveka.*)
python3 -m venv .venv
.venv/bin/pip install -e ".[dev]"

# 3. Migrations + seeds (idempotent — les URL connues sont ignorées)
pnpm crawl:seed          # = scripts/bootstrap-seeds/seed.sh → trouveka.crawler.seed

# 4. Frontend Next.js 15 (workspace pnpm)
pnpm install
pnpm dev                 # http://localhost:3000

# 5. Tests + garde-fous
.venv/bin/python -m pytest tests/    # 10 suites : fetcher, frontier, hybrid_search,
                                     # parser(+encoding), quebec_scoring, ranking,
                                     # ssrf, traps, urls
pnpm check:headers                   # header auteur obligatoire (CI)
Scripts pnpm du monorepo : dev · build · start (app web), crawl:seed, check:headers, deploy:m2m32. Côté ops : scripts/ka-sitemaps/ingest.py (alimentation par sitemaps), scripts/health-check/, scripts/eval/ (qualité de recherche), scripts/update-synonyms/, scripts/migrate-search-index/, scripts/cleanup-garbage.py, scripts/fix-mojibake/.
Variables d'environnement
Noms seulement — voir .env.example (jamais de secrets dans le repo) :
| Groupe | Variables |
|---|---|
| Bases de données | DATABASE_URL, REDIS_URL, SEARCH_URL, SEARCH_URL_BACKEND, PG_PORT, REDIS_PORT |
| Crawler | CRAWLER_USER_AGENT, CRAWLER_CONTACT_URL, MAX_GLOBAL_CONCURRENCY, MAX_PER_HOST_CONCURRENCY, DEFAULT_HOST_DELAY, MAX_RESPONSE_BYTES, MAX_REDIRECTS, FETCH_TIMEOUT, MAX_CRAWL_DEPTH, MAX_LINKS_PER_PAGE, MAX_URLS_PER_DOMAIN |
| API | API_HOST, API_PORT, ADMIN_TOKEN |
| Web | PUBLIC_URL, NGROK_DOMAIN, API_URL |
| Index & sémantique | SEARCH_INDEX, EMBEDDING_URL |
| SSO Groupe KA | KA_SSO_SECRET, KA_HUB_URL |
Données & conformité
- Un robot qui se présente : UA
TrouveKABotavec URL de contact (CRAWLER_CONTACT_URL), page publique /trouveka-bot qui explique qui il est, comment le bloquer ou l'inviter. - robots.txt d'abord : parsé avec Protego, mis en cache 24 h,
Crawl-delayhonoré ; politesse par hôte via verrou Redis (2 s par défaut), plafonds de concurrence globaux et par hôte. - Provenance des données : depuis le pivot du 2026-08-23, le moteur n'indexe que les 14 sites du Groupe KA (
ka_only=Truedanspackages/config) — du contenu de l'écosystème, découvert par seeds + sitemaps. La phase « web québécois ouvert » reste réactivable par configuration. - Fraîcheur sans gaspillage : ETag/If-Modified-Since, hash de contenu, recrawl adaptatif (×2 si inchangé, ÷2 si volatil) — on ne re-télécharge pas ce qui n'a pas bougé.
- Sécurité du fetch : garde SSRF (IP privées, loopback, métadonnées cloud bloquées, revalidée à chaque redirection), taille de réponse et redirections plafonnées, détection de pièges de crawl.
- Images : jamais crawlées ni copiées — hotlink avec attribution du domaine source.
- Rétention :
crawl_attempts30 jours,search_queries180 jours (purge quotidienne par le scheduler) ; backups quotidiens croisés Postgres + OpenSearch. - Métriques honnêtes : aucun compteur simulé nulle part —
/status,/stats, les pastilles de ce README et les rapports PDF lisent tous les mêmes données réelles. - Retrait : blocage de domaine via
/api/admin/domains/block— etTrouveKABotrespecte toutDisallowqui le vise.
Documentation
- Guide utilisateur illustré : www.trouve-ka.com/doc — la visite en 4 étapes (accueil, recherche, images, état du moteur + soumission de site).
- Guide PDF téléchargeable : trouve-ka-documentation.pdf.
- Architecture : docs/architecture.md (diagrammes Mermaid) · Décisions : docs/decisions.md · Runbook : docs/RUNBOOK.md (auto-guérison, backups, journaux, procédures).
- Le robot : /trouveka-bot — qui est
TrouveKABot, comment le bloquer ou l'inviter.
Structure du repo
apps/            # web (Next.js 15, moteur public + dashboard /admin) et api (FastAPI)
services/        # crawler, frontier, parser, classifier, indexer, ranking,
                 # scheduler, enrichment, embedding
packages/        # config, database, logging, queue, search-core, shared, types
infrastructure/  # docker/, migrations/, monitoring/, deployment/
scripts/         # bootstrap-seeds, ka-sitemaps, start-crawler, health-check, eval,
                 # ops, update-synonyms, migrate-search-index, cleanup-garbage,
                 # fix-mojibake, check-headers.py
tests/           # 10 suites : canonicalisation d'URL, SSRF, robots/frontier,
                 # scoring Québec, ranking, recherche hybride, parseur, encodage, pièges
docs/            # architecture.md, decisions.md, RUNBOOK.md, screenshots/
Le backend Python est un seul package namespace trouveka.* mappé sur ce layout (voir pyproject.toml — FastAPI, httpx, selectolax, protego, asyncpg, redis, opensearch-py, pydantic v2) ; le frontend vit dans un workspace pnpm.
Développement (remote-first)
La source de vérité est le repo git sur le nœud M2M32 (~/trouve-ka) — on n'édite jamais la copie laptop. Toute modification se fait sur le nœud via SSH : édition, build, pm2 restart, puis commit/push sur le nœud.
- Remote
origin= spbgit (git perso, https://git.spboucher.ai) — bare repo sur M3U96a, accessible via l'alias SSHgitsrvconfiguré sur les nœuds. Pas GitHub. - Agent forwarding actif : le
git pushfonctionne pendant une session SSH depuis le laptop.
ssh M2M32
cd ~/trouve-ka

# Backend Python (venv .venv, Python 3.12)
.venv/bin/python -m pytest tests/        # tests unitaires
python3 scripts/check-headers.py         # header auteur obligatoire (CI)

# Frontend Next.js
pnpm install
pnpm build                               # build de apps/web

# Appliquer un changement
pm2 restart tk-web                       # ou tk-api, tk-crawler-1, tk-crawler-2,
                                         # tk-enrichment, tk-scheduler, tk-sitemaps

git add <fichiers> && git commit -m "…" && git push origin main
Dev local complet possible : docker compose up -d postgres redis opensearch, pnpm crawl:seed (migrations + seeds), puis pnpm dev → http://localhost:3000.
Déploiement
- Nœud : M2M32 (
~/trouve-ka) — Mac Studio, 12 cœurs, 32 Go — plus M2M32b (index), m4mc (sémantique) et 4 satellites de crawl (voir Architecture). - Web :
tk-websur le port 3000, exposé sur https://www.trouve-ka.com. - Processus : PM2 (
pm2 ls→ tk-web, tk-api, tk-crawler-1/2, tk-enrichment, tk-scheduler, tk-sitemaps, tk-tun-search, tk-tun-embed) — auto-restart, survie au reboot. - Données : PostgreSQL 16 + Redis 7 en Docker sur M2M32 (
docker compose up -d postgres redis) ; OpenSearch 2.17 en Docker sur M2M32b. - Tunnel : ngrok sous launchd — label
com.trouveka.ngrok(~/Library/LaunchAgents/com.trouveka.ngrok.plist). - Auto-guérison : launchd
io.trouveka.boot(tous les nœuds),io.trouveka.watchdog(2 min), backupsio.trouveka.backup-pg/backup-os(quotidiens) — journaux~/trouveka-watchdog.log,~/trouveka-boot.log,~/trouveka-backups/backup.log.
ssh M2M32
cd ~/trouve-ka
pm2 ls                 # état des services
pm2 logs tk-crawler-1  # crawl en direct
docker ps              # postgres + redis (opensearch : docker ps sur M2M32b)
Runbook et observabilité : docs/RUNBOOK.md, dashboard /admin (files, débits, latences p50/p95, flux live) et infrastructure/monitoring/.
Historique
De la première ligne au moteur distribué et personnalisé du Groupe KA, en deux semaines :
| Date | Jalon |
|---|---|
| 2026-08-13 | Naissance (5eedcb2) — moteur de recherche Québec-first complet : crawler, index, ranking, API, web |
| 2026-08-16 | Recherche hybride sémantique + architecture native multi-nœuds (708a9ba) · auto-guérison, survie au reboot, backups croisés, rétention (78ddae6) |
| 2026-08-17 | Design Groupe KA + SSO KA ID (bf69142) · tableau de bord /stats + rapport PDF (93cbd33) · widget KA Agent (1676a98) |
| 2026-08-19 | Mobile-first (hamburger, safe-area, dvh — 37a4bf7) · KA Agent v2 plein écran + Markdown streaming (8bdbe5f) |
| 2026-08-22 | SEO complet — canonical, JSON-LD WebSite/SearchAction, sitemap, fr-CA (491f0f6) · standard header/menu KA (8678110) |
| 2026-08-23 | Pivot Groupe KA (42bf528) — le moteur n'indexe plus que les 14 sites KA ; rebrand « le moteur de recherche du Groupe KA » (fd0b68c) · stats v3, rapports PDF personnalisés (105720d) · favoris « Mon univers Ka » (1e29ebf) |
| 2026-08-24 | Documentation publique /doc + guide PDF (8880849) · README v2 puis v3 — l'index passe de 181 k à 302 k pages dans la journée |
| 2026-08-25 | Nav mobile v2 — panneau plein écran (8c96449, c343205) · widget ka-agent v4 → v4.2 — cartes d'annonces cliquables + choix en boutons (9f92551 → eee42bf) · campagne visuelle WebP (76fa1eb) |
| 2026-08-26 | KA ID v2 — journal des recherches vers le feature store du hub (0d63aa1) · KA ID v2.1 — reclassement personnalisé léger des résultats, fail-open (9ff0126) |
| 2026-08-28 | README v4 — visite guidée du site en 10 captures fraîches (docs/screenshots/) |
Écosystème Groupe KA
Les 14 sites marqués ● sont ceux que le moteur indexe en continu (les seeds du frontier) :
| Plateforme | Vocation | Indexé |
|---|---|---|
| groupe-ka.com | Portail du Groupe KA | ● |
| trouve-ka.com | Moteur de recherche — ce repo | ● |
| lou-ka.com | Logements à louer | ● |
| immo-ka.com | Propriétés à vendre | ● |
| vrai-prix.com | Estimation immobilière | ● |
| toit-ka.com | Louer ou acheter — les annonces réunies | ● |
| valoplex.com | Valeur immobilière, sans boîte noire | ● |
| auto-ka.com | Véhicules | ● |
| fabri-ka.com | Produits québécois | ● |
| food-ka.com | Épicerie et alimentation | ● |
| resto-ka.com | Restaurants | ● |
| sorti-ka.com | Sorties et événements | ● |
| job-ka.com | Emplois | ● |
| crea-ka.com | Créateurs | ● |
| api-ka.com | API de données (technique, non indexée) | — |
Contact
Simon-Pierre Boucher — fondateur, Groupe KA 📧 contact@spboucher.ai
© Groupe KA — Simon-Pierre Boucher · contact@spboucher.ai Ce repo vit sur spbgit (git.spboucher.ai), pas sur GitHub.